MD 08 (2): inferentie voor regressie
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/9

Earn XP
10 Terms
weke verdeling volgen de errors in de populatie
een Normale verdeling rond de regressierechte voor iedere x-waarde, met de gemiddelde y -waarde voor iedere x-waarde op de rechte
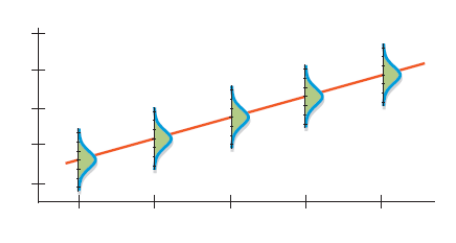
waar hangt de standaarddeviatie van de steekproevenverdeling van de richtingscoefficiënt van af
de spreiding rond de regressierechte
de spreiding van de x-waarden
de steekproefgrootte
wat geeft de standaarddeviatie van de residuen ons
een maat voor hoeveel de punten vraieren rond de regressielijn
spreiding rond de lijn moet overal hetzelfde zijn
waar is het gemakkelijker om een stabiele richtingscoefficient te schatten
bij een bredere range van x-waarden
we verwachten dat de richtingscoefficient minder varieert van steekproef tot steekproef bij een hogere sx
een hogere steekproefgrootte geeft meer consistente
schattingen voor de rico van steekproef tot steekproef
wat geeft je meer consistente schattingen van de rico (wat ook een kleinere standaardfout betekent)
minder spreiding rond de regressierechte, meer spreiding in de x-waarden en een grotere steekproef
om correcte inferentie te kunnen doen omtrent de regressiecoefficienten moeten aan volgende aannames en condities voldaan worden
aanname van lineariteit tussen x en y
onafhankelijke residueen
gelijke variantie rond de regressierchte
normaal verdeelde populatie : de residueen unimodaal en symmetrisch
inferentie voor een voorspelde waarde kan op 2 manieren
1) we wilen de gemiddelde y waarde voor alle items met een bepaalde x-waarde kennen
2) we willen de individuele y-waarde schatten voor een specifiek item bij een bepaakde x-waarde
→ voorspelde y^waarde is vor beide hetzelfde, maar het interval is veel breder bij individuele y waarden
hoe verder weg van x -
hoe meer onzekerheid op de voorspelling
het predictie interval i steeds
breder dan het overeenkomstig betrouwbaareidsinterval