Hva ser sensor etter
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/17

There's no tags or description
Looks like no tags are added yet.
18 Terms
Forutsetning uavhengig t-test
Uavhengige observasjoner (oppfylt — forskjellige individer i hver gruppe)
Normalfordelte data i hver populasjon
Lik varians i de to populasjonene (homogenitet)
Forutsetningene for paret t-test:
Differansene (D_i) er (tilnærmet) normalfordelte — ikke X og Y hver for seg, men differansen mellom dem
Differansene er uavhengige av hverandre — én persons endring påvirker ikke en annen persons endring
Paret vs uparet t-test
Paret tester avhengige utvalg, uparet tester uavhengige utvalg.
Interpolert varians
Vektet gjennomsnitt mellom variansen i to utvalg, brukt når man antar at de to populasjonene har lik varians
Ikke-parametrisk test
Ikke-parametrisk betyr at testen ikke bygger på en antakelse om at dataene følger en bestemt fordeling (typisk normalfordelingen) med bestemte parametere (μ og σ, "parametere" — derav navnet).
Når bruker man Mann-Whitney-Wilcoxon? Nevn forutsetninger
To uavhengige grupper, t-test-forutsetningene er ikke oppfylt. Forutsetninger: utvalgene er uavhengige, og sannsynlighetsfordelingene har samme form.
Z observator Mann-Whitney-Wilcoxon test
(observert − forventet under H0) / standardavvik til observatoren — samme mønster i alle tester.

R²

Andelen av variasjonen som forklares av modellen — det vi har snakket om.
Problemet med R² alene: R² kan aldri gå ned når du legger til flere forklaringsvariabler, uansett hvor ubrukelige de er. Legg til en helt tilfeldig, meningsløs variabel, og R² vil enten stå stille eller øke litt — aldri synke. Det gjør R² upålitelig til å sammenligne modeller med ulikt antall variabler, fordi en modell med flere variabler alltid vil "vinne" på ren R², selv om de ekstra variablene ikke tilfører noe reelt.
Justert R²
der n = antall datapunkter, k = antall forklaringsvariabler.
Denne straffer modellen for hver ekstra variabel som legges til. Hvis den nye variabelen ikke bidrar med nok forklaringskraft til å "betale for" plassen den tar opp, vil justert R² faktisk gå ned selv om vanlig R² går opp.
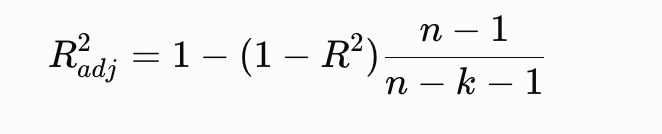
Konfunderende/bakenforliggende variabel =
Utelatt variabel som påvirker Y OG korrelerer med en X i modellen → gir feil (biased) koeffisienter for de inkluderte variablene.
Statistisk signifikans
"Statistisk signifikant" betyr at resultatet du observerer i utvalget ditt sannsynligvis ikke skyldes ren tilfeldighet — det er trolig en ekte effekt i populasjonen, ikke bare støy fra akkurat det utvalget du tilfeldigvis fikk.
Hva er et interaksjonsledd i regresjon, og hvorfor bruker man det?
Et interaksjonsledd lar effekten av én variabel avhenge av nivået på en annen variabel, i stedet for å anta at effekten er lik for alle (som i en vanlig additiv modell).
Lages ved: multiplisere de to variablene sammen, f.eks. ALDER_HEIM = ALDER × HEIM
Hvordan avgjør du om et kvadratisk ledd i regresjon gir et topp- eller bunnpunkt (vs. ingen vending)?
Bakside:
Se på fortegnet til b₁ (førstegradsledd) → forteller startretningen (positiv/negativ effekt ved lave verdier)
Sammenlign med fortegnet til b₂ (andregradsledd):
Motsatt fortegn → effekten er avtakende → snur → ekte topp-/bunnpunkt
Samme fortegn → effekten er tiltakende → ingen vending
Hvis motsatt fortegn — type vending avgjøres av b₂'s fortegn:
b₂ positiv → U-form → bunnpunkt
b₂ negativ → snudd U-form → toppunkt
Eksakt vendepunkt:

Problemer med inkludere polynomer av høyere orden i regresjonmodeller
1. Multikollinearitet. Høyere-ordens polynomledd (x, x², x³, x⁴...) av samme variabel er ofte sterkt korrelert med hverandre. Det gir ustabile koeffisientestimater og store standardfeil — som igjen gjør det vanskeligere å oppdage reelle signifikante effekter, selv om de finnes.
2. Overtilpasning (overfitting). Med nok polynomledd kan modellen tilpasse seg akkurat dataene i utvalget ditt — inkludert den rene tilfeldige støyen. Da blir modellen dårlig til å generalisere til nye data utenfor utvalget, selv om den ser "imponerende god" ut på papiret (høy R² på treningsdataene).
3. Unødvendig kompleksitet. Flere polynomledd gjør modellen vanskeligere å tolke — jo flere ledd, jo mer abstrakt blir det å forklare hva modellen faktisk sier om sammenhengen.
4. Upålitelige prediksjoner i randsonene. Høyere-ordens polynomer kan svinge kraftig utenfor det området dataene faktisk dekker — så prediksjoner nær eller utenfor grensene av det observerte dataområdet blir upålitelige (polynomer har en tendens til å "eksplodere" i hver ende).
Enveis vs toveis variansanalyse
Forside: Hvorfor sammenligner man F-verdi med kritisk verdi i ANOVA?
F=MSEMSA=tilfeldig, uforklart variasjonvariasjon forklart av faktoren
Hvis H0 er sann (ingen effekt), forventes F ≈ 1. Jo større F, jo mer tyder det på en reell effekt.
Kritisk verdi = terskelen for hvor stor F kan bli av ren tilfeldighet (maks 5% av tilfellene), hentet fra F-fordelingen med riktige frihetsgrader (teller: a−1, nevner: (a−1)(b−1) for toveis).
Beslutningsregel:
F ≥ kritisk verdi → forkast H0 (reell effekt)
F < kritisk verdi → ikke forkast H0
Sjekk alltid mot p-verdien (samme konklusjon, to måter å lese samme resultat på): p < 0,05 ⟺ F ≥ kritisk verdi.
Nominale variabler i regresjonsanalyse.
Hvis variabel er nominal (uten rangering): Slike variabler må alltid inkluderes i regresjonsmodeller ved hjelp av dummykoding. Har variabelen n antall kategorier, må den inkluderes som n-1 dummyvariabler, der den utelatte kategorien blir modellens referansekategori. Grunnen til at en utelates, er for å unngå perfekt multikollinearitet.
Ordinale variabler i regresjon
Siden variabelen er på ordinalnivå, kan den i prinsippet inkluderes i modellen både som en pseudo-kontinuerlig variabel og som et sett med dummyvariabler