HOC 3: Werken met strings
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/48

There's no tags or description
Looks like no tags are added yet.
49 Terms
nchar()
number of characters: telt het aantal tekens
tolower()
convert to lower case: zet alles in kleine letters
toupper()
convert to upper case: zet alles in hoofdletters
casefold()
case folding: om alle letters in een tekst (string) om te zetten naar kleine letters of hoofdletters
heeft 1 belangrijke parameter genaamd upper:
upper = FALSE(standaard): zet tekst om naar kleine letters (lowercase).upper = TRUE: zet tekst om naar hoofdletters (uppercase).
chartr()
character translation: bepaalde tekens in vector omzetten naar andere (bv.: om van DNA naar RNA te gaan “T” vervangen door “U”)
abbreviate()
abbreviation: de vector afkorten naar een gevraagd aantal tekens
substring()
substrings of a character vector: een deel van een tekststring (of vector van strings) te extraheren
substr()
substrings of a character vector: een deel van een tekststring (of vector van strings) te extraheren
substr() vs substring()
substr(): je moet een specifieke stopwaarde aangeven (bv.: als je bij een string van 23 tekens van teken 3 tot het laatste teken wilt zien, moet je een specifieke waarde geven (de naam/het cijfer tot waar je wilt); dus: van 3 tot 23)
substring(): je moet geen stopwaarde geven (bv.: als je bij een string van 23 tekens van teken 3 tot het laatste teken wilt zien, moet je geen specifieke waarde geven (je mag “last” gebruiken om de gegevens tot het einde te krijgen); dus: van 3 tot last)
length()
telt het aantal elementen
length() vs nchar()
length(): telt het aantal elementen in de vector
nchar(): telt het aantal tekens in de elementen
sep =
een separator: is een scheidingsfunctie
sep = “ “
sep = “,”
sep = “.”
sep = “_”
…
sep = “ “ : er is geen scheiding
sep = “,” : elementen worden gescheiden door een komma
sep = “.” : elementen worden gescheiden door een punt
sep = “_” : elementen worden gescheiden door een laag streepje
…
collapse
voegt elementen v.h. resultaat samen tot 1 string
readline()
geeft tekst terug
trimws()
verwijdert buitenste witruimte
grepl()
zoeken naar tekstpatronen (reguliere expressies) binnen een tekst of een vector van teksten; antwoord is altijd TRUE of FALSE
bv.:
we hebben een lijst met fruitsoorten:
fruit <- c("appel", "banaan", "aardbei", "peer")
als we willen controleren welke vruchten de letters "aa" bevatten, gebruiken we grepl():
grepl("aa", fruit)
resultaat
[1] FALSE TRUE TRUE FALSE
"appel" en "peer" bevatten geen "aa" (
FALSE)."banaan" en "aardbei" bevatten wel "aa" (
TRUE).
\n
nieuwe regel
print() vs cat()
print():
laat ruwe data zien zoals R deze intern opslaat
result1 ← print(Text)
geeft de waarde volledig terug
cat():
( = concatenate, samenvoegen)
maakt tekst mooi leesbaar voor de gebruiker
result2 ← cat(Text)
geeft zelf geen bruikbare data terug aan R
het resultaat is leeg ( NULL )
complement
vervangt basen
reverse complement
vervangt basen en keert daarna de volgorde om
1) basen vervangen (complement maken)
r
# Voorbeeldsequentie
dna <- "ATGCGT"

# Vervang A->T, T->A, C->G, G->C
complement <- chartr("ATCG", "TAGC", dna)
print(complement)
# Output: "TACGCA"
2) complement omkeren
r
# 1. Knip de string in losse karakters (geeft een lijst terug)
gesplitst <- strsplit(complement, split = "")

# 2. Haal de losse letters uit de lijst en draai de volgorde om
omgedraaid <- rev(gesplitst[[1]])

# 3. Plak de letters weer samen tot één string
reverse_complement <- paste(omgedraaid, collapse = "")
print(reverse_complement)
# Output: "ACGCAT"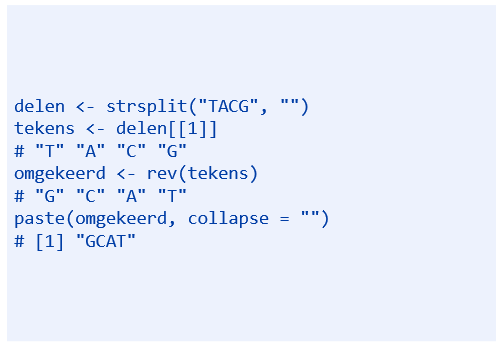
package installeren
install.packages()
install.packages(“readxl”)
installeert readxl
library(readxl)
maakt de functies beschikbaar zonder voorvoegsel
head(x)
toont eerste rijen v. een dataset
str(x)
toont de structuur en types v. een dataset
welk gereedschap past bij h. bestand? (bekijken)
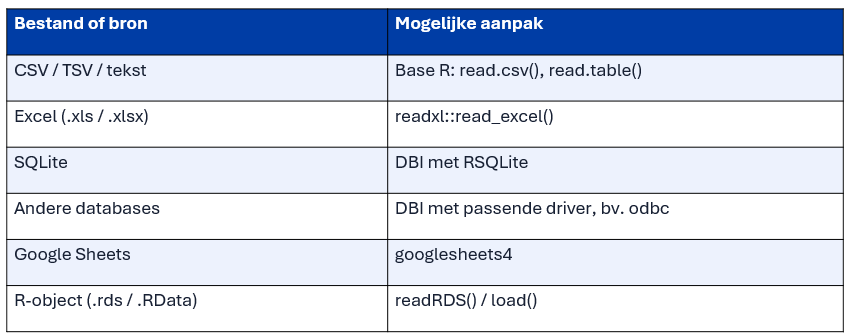
read.csv()
gebruikt standaard komma’s als scheiding
read.cvs2()
gebruikt puntkomma’s en een decimale komma als scheiding
leesbaar programmeren
betekenisvolle namen
tips:
gebruik letters, cijfers, punten en underscores
vermijd gereserveerde woorden zoals “if” en “for”
R onderscheidt hoofdletters v. kleine letters!!!
bv.: staal_id, bereken_bmi,…
structuur v. een script
splits code op → samenhang verbetert
beschrijf bovenaan h. doel
commentaar en witruimte: maak redenering leesbaar
commentaarregel begint met #
blokken en inspringing: consistente opmaak helpt fouten zien
zet bij vooerkeur een if-blok op dezelfde regel als de voorafgaande accolade
uitvoer vs. teruggegeven waarde

soorten vectoren
1) atomaire vectoren (homogeen)
eendimensionale reeksen waar elk element verplicht v. hetzelfde gegevenstype is
soorten:
double (or numeric): slaat decimale getallen op
integer: bevat uitsluitend gehele getallen
logical: vertegenwoordigt logische waarden die alleen
TRUEofFALSEkunnen zijncharacter: voor tekst en tekenreeksen
complex: slaat complexe getallen op met een reëel en imaginair deel
raw: bewaart gegevens op het laagste niveau, als ruwe bytes
2) lijsten (heterogeen)
gemengde inhoud: kunnen verschillende gegevenstypes tegelijk bevatten
geneste structuur: kan bv. een combinatie v. getallen, tekst en zelfs andere lijsten opslaan
3) afgeleide objecten
R bouwt complexere structuren door extra eigenschappen aan vectoren of lijsten toe te voegen
soorten:
matrices en arrays: voegen structuren (rijen en kolommen) toe aan atomaire vector
factors: atomaire integer-vectoren met tekstlabels
voor categorische data
date time: datum- en tijdobjecten zijn numerieke atomaire vectoren die h. aantal dagen of seconden sinds een startdatum tellen
data frames: bekende datatabellen; zijn technisch gezien lijsten waarin elke kolom een atomaire vector van gelijke lengte is
“complex” objects: geavanceerde structuren, zoals de resultaten van een statistisch model, combineren vaak zowel lijsten als atomaire vectoren

datatypes

dimensieonaliteit: reeks, tabel of meerdere lagen

verschillende soorten structuren

c()
maakt een character-vector
bv.: c(12, “bloed”)
kenmerken factoren
representeren categorische variabelen
bevatten integercodes met labels in levels
kunnen geordend of ongeordend zijn
numeriek label is niet hetzelfde als numerieke meting
byrow
in welke volgorde gegevens in een matrix worden geplaatst
standaard staat deze waarde op
FALSER vult matrix altijd kolom voor kolom in plaats van rij voor rij
bv.:
r
# 1. Standaard (byrow = FALSE): vult per kolom
matrix(1:6, nrow = 2, ncol = 3, byrow = FALSE)
# Resultaat:
#      [,1] [,2] [,3]
# [1,]    1    3    5
# [2,]    2    4    6

# 2. Met byrow = TRUE: vult per rij
matrix(1:6, nrow = 2, ncol = 3, byrow = TRUE)
# Resultaat:
#      [,1] [,2] [,3]
# [1,]    1    2    3
# [2,]    4    5    6
diag()
maakt een diagonaalmatrix met het argument

rbind()
om vectoren, matrices of data frames verticaal onder elkaar te plakken tot één groter object
bv.:
r
# Twee kleine data frames maken
df1 <- data.frame(Naam = c("Jan", "Piet"), Leeftijd = c(25, 30))
df2 <- data.frame(Naam = c("Klaas", "Marie"), Leeftijd = c(28, 35))

# Samenvoegen onder elkaar
totaal <- rbind(df1, df2)cbind()
om vectoren, matrices of data frames horizontaal aan elkaar te plakken tot één groter object
%*%
berekent het matrixproduct → ncol(A) = nrow(B)
$-operator
algemene schrijfwijze is
objectnaam</code></p></li><li><p>omeenspecifiekonderdeel(zoalseenkolomofelement)bijnaamoptehalenofaantepassenuiteendataframe,eenlijst(list)ofeenenvironment</p></li><li><p>bv.:</p><ul><li><p><span><strong>kolomuiteendataframehalen:</strong></span></p><ul><li><p><span>stel:datasetmetdenaam</span><code>klanten</code><span>endaarinziteenkolom</span><code>leeftijd</code></p></li><li><p><code>klantenleeftijdgeeft je alle waarden uit die kolom als een vector
nieuwe kolom toevoegen:
je kunt de operator ook gebruiken om data toe te voegen of te overschrijven
met
klantenland<−"Belgie¨"</code><span>maakjedirecteennieuwekolomaan</span></p></li></ul></li></ul><p></p><ul><li><p><span><strong>elementuiteenlijst(list)selecteren:</strong></span></p><ul><li><p><span>bijeenlijstwerkthetprecieshetzelfde</span></p></li><li><p><span>als</span><code>mijnlijst</code><span>eenonderdeel</span><code>scores</code><span>heeft,roepjedatopmet</span><code>mijnlijstscores
bij dataframes/matrices: [[ ]]
neemt de inhoud v. 1 kolom
bij dataframes/matrices: [ ]
[ ] met een kolomnaam bewaart een dataframe
apply(), lapply(), sapply()
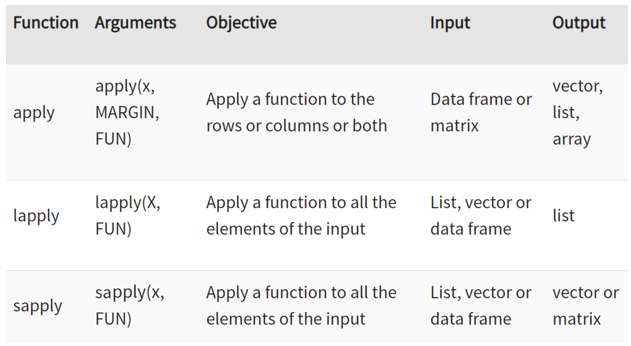
bij for-lus: for (i in seq_along(x))
lus waarbij voor elk element in het object x één keer wordt uitgevoerd, waarbij de variabele i steeds de positie (index) van dat element aanneemt
lus stoppen
break
“next” bij een lus
om de rest v.d. huidige iteratie (stap) in een lus over te slaan en direct door te gaan naar de volgende iteratie
de lus zelf wordt hierdoor dus niet afgebroken, maar hervat meteen bij de volgende waarde