Intro Machine Learning
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/28

There's no tags or description
Looks like no tags are added yet.
29 Terms
Tipi di pattern
Categorici (caratteristiche qualitative, possono essere multilabel)
Numerici (caratteristiche misurabili, feature vectors, ordinabili)
Sequenze (sequenze di pattern, ordine e relazione con altri della sequenza conta)
Task del ML
Classificazione (associare ogni pattern a una classe, ovvero insieme di pattern con caratteristiche simili, binary o multi-class classification)
Segmantazione (assegnare ogni pixel un etichetta)
Clustering (individuazione di gruppi (cluster) di pattern con caratteristiche simili, cluster usabili per classificazione)
Regressione (assegna valore continuo a pattern)
Riduzione Dimensionalità
Tecnica usata per ridurre la dimensione del problema semplificandono. La riduzione avviene rimuovendo featurs vai vettori (non vengono rimosse ma accorpate tra loro). Perdita informazioni. Mantengo info importanti
Feature Learning vs Rapresentation Learning
Feature Learning = l’esperto definisce features ad hoc per le diverse applicazioni
Representation Learning = il modello definisce automaticamente queste features. Nel deep learning, vengono anche classificate gerarchicamente
Computer Visione
Classification (etichettare oggetto)
Localization (etichettare e localizzare oggetto)
Detection (etichettare e localizzare tanti oggetti)
Segmentation (etichettare e segmentare tanti oggetti)
Tipologie Aprendimendo
Supervisionato (training set etichettato)
Semi-supervisionato (training set semi-etichettato, definisco alcune label, etichetto resto training set in base a vicinanza a singola label in base a un bound calcolato da algoritmo)
Non supervisionato (training set non etichettato)
Modalità di apprendimento
Batch (impara una volta, entra in working mode)
Incrementale (il modello può imparare più volte, ma rischio di Cathastrophic Forgetting (dimentica ciò imparato in passato))
Naturale (il modello non smette mai di imparare, parte con alcune etichette)
Reinforcement learning
L’obiettivo è trovare la soluzione ottimale. Ciò avviene attraverso sistemi di reward, ovvero premi dati al modello in base a una scelta fatta (se corretta). L’obiettivo è quello di massimizzare i reward, e quindi ottimizzare risultato. Approccio supervisionato poco efficace
Definizione parametri
Si utilizzano dei set di parametri per regolare apprendimento modello. Il valore ottimale di questi parametri si ottiene massimizzando la funzione f(Train,p) oppure minimizzando quella di errore. Anche la f(Train,p) può essere ottimizzata in due modi:
esplicitamente: metodi matematici come derivate
implicitamente: utilizzando euristiche. Es: algoritmo k-means nel clustering, basato sulla definizione di k gruppi con un centroide interno. Centroidi aggiornati iterativamente fino alla convergenza, ovvero quando le assegnazioni di punti ai cluster (e quindi le posizioni dei centroidi) non è più signifiacativa
Iperparametri
definiscono struttura o modo apprendimento del modello. Da definire pre-addestramento.
Si prendono valori ragionevoli degli iperparametri, si runnano test e si prendono quello che hanno restituito prestazioni migliori
parametri vs iperparametri
parametri: appresi automaticamente dal modello in base ai dati
iperparametri: definiti prima dell addestramento del modello
Valutazione prestazione
Classificazione: pattern giustamente classificati / pattern classificati. Possibile sbilanciamento se non viene predetta una certa calsse, quindi conviene matrice di confusione che deve essere diagonale o (possibilmente) di identità
Regressione: RMSE

Closed set vs open set
closed set: numero di classi ben preciso
open set: ho k classi + resto del mondo
Soglia T
Serve a imporre un limite inferiore affinché la classificazione dell oggetto possa essere considerata giusta in base alla probabilità p che appartenga a quella classe. Una soglia elevata comporta più FN, una soglia bassa comporta più FP

Accuracy
Si ottiene con questa formula
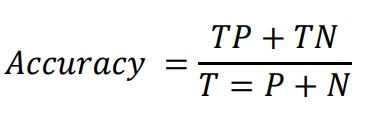
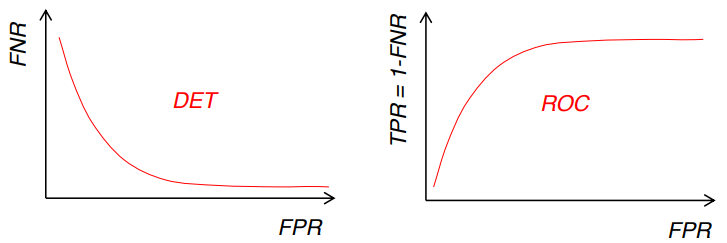
ROC vs DET
DET (Detection Error Tradeoff): mette in rapporto FNR e FPR levando la soglia
ROC (Receiver Operating Characteristic): stesso ma sostituisce il FNR con TPR

Come decido quale è migliore?
Per determinare il sistema migliore, si utilizza la AUC (Area Under Curve). Ovvero, si calcola l’integrale dell’area sotto la curva per ottenere il valore medio e si prende il sistema con AUC maggiore


Precision vs Recall
Sono notazioni usate nella Information Retrieval (ricerca di google) e indicano:

F1-Score e Precision-Recall Trade-Off
Metrica combinata di Precision e Recall per confrontare due classificatori. È data dalla media armonica dei due, questo perché la media armonica da più peso a valori più bassi. Dunque, un classificatore sarà elevato solo se elevate Precision e Recall.
Inoltre, F1-Score favorisce classificatori con Precision e Recall simili, questo però non è sempre possibile e utile (video sicuri per bambini meglio alta Precision, video sorveglianza meglio alta Recall). Inoltre, l’aumento di uno comporta la diminuzione dell’altro per questo si parla di Precision-Recall Trade-Off

Sesitivity vs Specificity

Object Detection: errori e confonto
Consiste nell’individuare e assegnare a ogni classe una bounding box con una certa probabilità.
Si possono verificare errori (oggetto non trovato, imprecisione, classe errata), dunque per confrontare più sistemi si utilizzato degli scalari:
AP(Avarage Precision): AUC calcolata su grafico Precisio/Recall per oggetti di una singola class. Disegnando l’AP notiamo che la Precision varia con valori alti o bassi, mentre la Recall sale sempre
mAP(Medium AP): la media di tutte le AP
IoU (Intersection over Union): misura il grado di sovrapposizione tra due bounding box. Si usa per valutare quanto il bounding box predetto si sovrapponga al ground truth, cioè al bounding box che delimita l’oggetto reale. In alcuni dataset si fissa una soglia di IoU, per esempio 0.5.
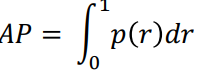
Training, Validation, Test
Trainint set: insieme di pattern su cui addestrare il sistema, trovando il valore ottimo per i parametri
Validation set: insieme di pattern su cui tarare gli iperparametri H (ciclo esterno)
Test set: insieme di pattern su cui valutare le prestazioni finali del sistema (MAI utilizzare test set come training set, altrimenti valori valutazione finale sballati)
Spesso nei benchmark la suddivisione dei pattern in Train, Valid e Test è spesso predefinita, ma in caso non lo sia, con dati sufficientemente grandi possiamo usare Set Disgiunti.
K-Fold Cross-Validation e Leave-one-out
Procedura per scelta robusta iperparametri (obbligatoria per dataset di piccole dimensioni).
Per ogni combinazione di iperparametri Hi che si vuole valutare:
-Si esegue 5 volte il training scegliendo uno dei fold come Valid e i 4 rimanenti come Train.
-Si calcola l’accuratezza avg_acci come media/mediana delle 5 accuratezze sui rispettivi Valid
-Si sceglie la combinazione di iperparametri con migliore avg_acc.
-Scelti gli iperparametri ottimali si riaddestra il modello su tutto il training set (5 fold) e, solo a questo punto, si verificano le prestazioni sul test set.
Leave-one-out: caso estremo di cross-validation dove i fold hanno dimensione 1. Visto il costo computazionale, si utilizza quando i pattern sono pochi (es. meno di 100).

Scelta automatica degli iperparametri
Grid Search: per ogni iperparametro si definisce un insieme di valori da provare. Il sistema è valutato su tutte le combinazioni di valori di tutti gli iperparametri. Può essere molto costoso: raffinamento incrementale dei valori. Attenzione inoltre se vengono selezionati valori di bordo per uno o più iperparametri.
Random Search: sorteggia casualmente valori di iperparametri dai range/distribuzioni specificati/e, eseguendo un numero prefissato di iterazioni.
Bayesian Optimization: tale tecnica di ottimizzazione sfrutta il teorema di Bayes per trovare la giusta combinazione di iperparametri nei casi di reti neurali profonde, ovvero modelli con funzioni molto complesse cariche di iperparametri.
Evolutionary Optimization: tale tecnica (la più affascinante) si basa sul concetto biologico di evoluzione: la popolazione più forte e adattiva, è la popolazione vincente. Per popolazione in questo frangente si intende popolazione di iperparametri. I principali algoritmi dell’ottimizzazione evolutiva sono gli Algoritmi Genetici, che sfruttano i concetti biologici di mutazione, crossover e selezione.
Convergenza
Il primo obiettivo da perseguire durante l’addestramento sul Train set. Consideriamo un classificatore il cui addestramento prevede un processo iterativo. Si ha convergenza quando
-La loss (output della loss function) ha andamento decrescente
-L’accuratezza ha andamento crescente
Note:
-Se la loss non decresce (o oscilla significativamente) il sistema non converge
-Se la loss descresce ma l’accuratezza non cresce, probabilmente è stata scelta una loss-function errata
-Se l’accuratezza non si avvicina al 100% sul Train, i gradi di liberta del classificatore non sono sufficienti per gestire la complessità del problema

Gradi di Libertà
Il numero di parametri liberi che il modello può modificare durante il training, dunque la flessibilità che ha il modello nell’adattarsi ai dati. Più dati = più relazioni complesse tra input e output realizzabili
Dunque:
-Pochi gradi: underfitting (accuratezza lontana dal 100%) modello non riesce a rappresentare complessità problemi
-Troppi gradi: overfitting modello memorizza dati training, rumore incluso, invece di imparare pattern genuini
Generalizzazione, Overfitting e early stopping
Per generalizzazione intendiamo la capacità di trasferire l’elevata accuratezza raggiunta su Train a Valid. Se i gradi di libertà del classificatore sono eccessivi, si raggiunge elevata accuratezza su Train, ma non su Valid (scarsa generalizzazione). È dunque buona norma partire con pochi gradi di libertà e mano mano aumentarli tenendo sotto controllo accuratezza Train e Valid. A questo scopo si aggiunge un fattore regolarizzante alla loss-function per penalizzare soluzioni complesse o irregolari, in modo da garantire regolarità della soluzione
Nei processi di addestramento iterativo, tipicamente dopo un certo numero di iterazioni l’accuratezza su Valid non aumenta più (e può iniziare a decrescere) a causa dell’overfitting. Monitorando l’andamento si può arrestare l’addestramento nel punto ideale (early stopping)

Affidabilità Statistica
Confrontare i modelli solo in base ai dati grezzi è insufficiente, dunque bisogna attuare test di significatività statistica
Processo finale da tenere a mente
- Non utilizzate approcci di Machine Learning per problemi sui quali non avete a disposizione sufficienti esempi per il Training e il Test.
- Collezionare esempi (ed etichettarli) può richiedere ingenti sforzi (non conviene)
- Collezionate pattern rappresentativi del problema da risolvere e distribuiteli adeguatamente tra Train, Valide e Test.
- Evitate di concentrarvi solo su casi troppo semplici (ad esempio rimuovendo iterativamente i pattern che il vostro approccio non riesce a gestire).
- Automatizzate «subito» al meglio le procedure di valutazione delle prestazioni, le eseguirete molte volte
- Confrontate le prestazioni del vostro sistema solo con altri addestrati sullo stesso dataset e con lo stesso protocollo.
- Attenzione all’affidabilità statistica dei risultati su set di piccole dimensioni. Intervalli di confidenza e simulazioni su più Run (al variare delle condizioni iniziali) possono aiutarvi.
- Infine (ma estremamente importante): scrivete codice strutturato, ordinato, eseguite debug incrementale e unit testing. Gli algoritmi di Machine Learning non sono «esatti» e trovare bug nel codice può essere molto difficile!