Embedded Systems 2
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/52

There's no tags or description
Looks like no tags are added yet.
Name | Mastery | Learn | Test | Matching | Spaced | Call with Kai | Chat |
|---|
No analytics yet
Send a link to your students to track their progress
53 Terms
Was ist das Hauptziel der Systemintegration?
Systemkomponenten und Subsysteme so zusammenzuführen, dass sie als geschlossenes Ganzes funktionieren.
Welche Art von Anforderung beschreibt, WIE das System seine Funktionen ausführt (z. B. Geschwindigkeit, Zuverlässigkeit)?
Non-Funktional
SMART Kriterien
Specific
Measurable
Attainable » Realistisch
Relevant » Relevant für den Porjektfortschritt
Time-Bound
Hauptunterschied zwischen Wasserfallmodell und V-Modell
Wasserfallmodell
Sequentiell (Schritt für Schritt)
Keine parallele Entwicklung
Anforderungen werden zu Beginn gesammelt/entwickelt
Nachträgliche Änderungen in abgeschlossenen Schritten sind kostspielig/aufwendig
V-Modell
Parallele Planung von Entwicklungs- & Testschritten
Jeder Entwicklungsschritt hat einen korrespondierenden Testschritt
Vorteil: Defekte können durch kontinuierliche Tests früh gefunden werden
Nachteil: Auch hier » späte Änderungen kostspielig
Unterschied Verifikation & Validierung
Beispiel: Ein Haus bauen
Verifikation:
Haben wir es richtig gebaut?
Umsetzung
z. B. Haben wir das richtige Material verwendet?
Validierung:
Haben wir das Richtige gebaut?
Ergebnis/Nutzen
z. B. Gibt es in einem Haus genügend Räume?
Definition: Stakeholder
Person/Gruppe/Organisation die Interesse am Verlauf oder Ergebnis eines Projektes hat oder direkt oder indirekt vom Projekt(ergebnis) beeinflusst wird
Definition: Systems Engineering
Inhalte
Frühphase: Definierung und Dokumentation von Systemanforderungen
Systemdesign
Verifikation des Systems anhand der formulierten Anforderungen
Teilgebiete:
Projektmanagement
Anforderungsanalyse & -management
Systemdesign
Systemvalidierung & -verifikation
Systemintegration
Risikomanagement
Funktionale & Non-Funktionale Requirements
Funktionale Requirements:
Aktionen des Systems (z.B. Systemverhalten)
WAS macht das System?
Non-funktionale Requirements:
Performance des Systems
WIE performt das System?
CONSENS
Überführung der ersten Produktidee zur technischen Leistungsbeschreibung
beginnt nicht direkt mit Anforderungen, sondern analysiert zuerst das Systemumfeld, externe Einflüsse, Schnittstellen und alle Stakeholder
Nutzer- und lebenszyklusorientiert: Anwendungsszenarien betrachten nicht nur den Endnutzer, sondern z. B. auch Montage, Service, Logistik, Zulassung und Entsorgung.
Für interdisziplinäre Entwicklungsteams: Vor allem für Systems Engineers, Requirements Engineers sowie Hardware-, Software- und Regelungstechniker, die früh ein gemeinsames Systemverständnis benötigen.
Agile Methoden
Alternative zu klassischem Projektmanagement
Iterativer Prozess
Ergebnisse > Dokumentation
Fokus auf Kundenfeedback und schnelle Ergebnisse
Späte Änderungen sind nicht so kritisch
Oft SCRUM oder SCRUM-ähnlich (Hybride Ansätze)
Lean Startup
Früh Annahmen/Prototypen testen, statt exzessiver vorzeitiger Planung
MVP (Minimum viable Product) früh bauen
Kundenfeedback frühzeitig messen oder beobachten
Anhand Feedback und ersten Annahmen/Tests den Projektplan anpassen
Vorgehen reduziert das Risiko eines überflüssigen Produkts

Kanban
Kanban: Visualisierung aller Aufgaben auf einem Kanban Board
Agile Methode
Unterteilung in Backlog, Doing, Review, Done
Jeder Mitarbeiter sucht sich selbst die Aufgaben
Oft Limits pro Kategorie
Nicht unendliche viele offene Aufgaben gleichzeitig
Lead Time: Zeitmessung vom Start der Bearbeitung bis Fertigstellung einer Aufgabe
Nicht unendliche viele offene Aufgaben gleichzeitig
Lead Time
Lead Time: Zeitmessung vom Start der Bearbeitung bis Fertigstellung einer Aufgabe
Typischerweise bei Agiler Planung (z.B. Kanban)
Extreme Programming (XP)
Agile Methode (iterativ), bezogen auf Softwareentwicklung
Fokus auf Qualitätssteigerung der Software bei gleichzeitiger Reaktionsfähigkeit
Shared Code/Collective Coder Ownership → Keine Inselbildungen, Jeder kann Änderungen vornehmen
Gleicher Code Standard im gesamten Projekt
Überflüssigen Code direkt löschen
Immer die simpelste Lösung wählen
Regelmäßige Code-Reviews/Refactoring: Bestehenden Code prüfen und optimieren (u.a. auch aufräumen)
Test Driven Development (TDD): Automatisierte Tests werden vor dem Code geschrieben
» Hilft dabei Fehler früh zu finden
Parallele Reviews durch zweite Person (“Pair Programming”)
» Soll Code Qualität verbessern
Customer on site/Kunde vor Ort: Kundenvertreter sollte stets verfügbar sein, um Anforderungen und Prioritäten zu klären » Entwickler können schnell Freigaben oder Änderungen erhalten
Nutzt teilweise auch User Stories als Requirement
Unterschied Lean Startup und Extreme Programming
Lean Startup: Fokus auf das gesamte Produkt
XP: Fokus auf Software
SCRUM - Kernthemen
Agile Methode
Iteratives Vorgehen in Sprints oder Iterationen
Kontinuierlicher Feedbackloop mit Stakeholdern
Wechselnde Anforderungen im Laufe des Projekts sind nicht nur akzeptiert sondern sogar willkommen
SCRUM - Rollen
Product Owner:
Verwaltet den Product Backlog
Erstellt und verwaltet User Stories
Erstellt und verwaltet restliche Aufgaben
Setzt Prioritäten
Stellt sicher, dass das Entwicklungsteam die Kundenanforderungen umsetzt
SCRUM Master:
Eine Art Projektleiter
Plant Prozesse/Meetings
Moderation der Meetings
Ist für Einhaltung der SCRUM-Standards verantwortlich
Entwicklungsteam:
Für die Ausführung der User Stories (im Product Backlog) zuständig
Nimmt an Meetings teil
Für funktionierendes Produkt verantwortlich
User Stories
Scrum spezifisch
Eine kurze Beschreibung einer Systemanforderung aus der Sicht einer speziellen Perspektive (Rolle, z.B. Nutzer oder Entwickler)
Formulierung:
Was braucht eine Rolle?
Warum braucht es dieses Feature?
Formulierungen haben hohen Detailgrad und werden kontinuierlich angepasst (Backlog Refinement)
z.B.: “As Administrator I want to delete a user, to save administration effort for invalid users.“
Jede User Story hat feste Akzeptanzkriterien:
konkrete, überprüfbare Bedingungen
müssen erfüllt werden, damit sie als vollständig umgesetzt und erfolgreich akzeptiert gilt
SCRUM - Ablauf
allg.: Mehrere Sprints (meist 1-4 Wochen)
Sprint Planning/Backlog Refinement
ggf. mit Planning Poker
Ziel: Fertige Backlog Items für den aktuellen/nächsten Sprint
Schritte:
Schätzung der Kapazität (Angabe in Manntagen, Verrechnung von Abwesenheiten)
Formel: Sprintdauer * Teamgröße - Abwesenheiten
Schätzung des Sprintvolumen
Formel: Kapazität / Max. Kapazität * Geschwindigkeit
Geschwindigkeit wird durch Analyse des Backlog Refinement (geschätzter Aufwand, abgeschlossene Tasks) bestimmt
Priorisierung von User Stories
Festes Sprintziel festlegen
Moderiert durch SCRUM Master
Durchführung
Scrum Dailies: Tägliche Meetings, ca. 15 Minuten
Sprint Review
Abschlusspräsentation des aktuellen Sprints
Implementierungen werden den Stakeholdern vorgestellt
Typischerweise 2-4h (je nach Sprintdauer)
Sprint Retrospective
Reflektierung des aktuellen Sprints
Was lief gut? Was lief schlecht?
z.B. über Dot Voting (jeder Mitglied kriegt feste Anzahl an Voting Punkten für feste Verbesserungsvorschläge)
Einbringen von Verbesserungsvorschlägen für den nächsten Sprint
Burndown Chart
Grafische Gegenüberstellung der verbleibenden Zeit und Arbeit während eines Sprints
SCRUM: Planning Poker
Teil des Backlog Refinements/Sprint Plannings
Jedes Teammitglied (Entwicklungsteam) schätzt den Aufwand pro Feature (z.B. Zahlenwerte)
Bei starken Abweichungen wird diskutiert und neu bewertet
Vorteile RTOS
Determinismus und Echtzeitfähigkeit
Wartbarkeit & Struktur
Prioritätsbasiertes Scheduling
Portabilität und Skalierbarkeit
Mögliche Task-States (Zustände)
Running: Läuft aktuell
Ready: Bereit für Ausführung, wartet gerade (z.B. bis höherpriorisierte Task fertig ist)
Blocked: Wartet auf externes Event, kann solange nicht laufen bis die unblocking Bedingung erfüllt wird
Suspended: Nicht im Scheduling Prozess, muss erst unsuspended werden (normalerweise ein manueller Prozess)
Scheduling Verfahren
Übergeordnet
preemptive: CPU/Scheduler kann aktuell laufende Tasks unterbrechen, um z.B. höherpriorisierte auszuführen
non-preemptive: CPU/Scheduler muss warten bis aktuelle Task beendet ist, danach z.B. Priorisierung in Queue
Varianten:
Prioritätsbasiert: Jede Task hat ein Prioritätslevel, Scheduler wählt immer die Task mit höchster Prio
Round-Robin: Time-Slicing, CPU-Zeit wird geteilt wenn mehrere Tasks mit gleicher Priorität laufen
Time Triggered: Deterministische zeitliche Abfolge, vorher festgelegt, keine Prioritäten
Höher Priorität = Frühere Ausführung (FreeRTOS)
Idle-Task hat Prio = 0
Achtung!: niedrig priorisierte Tasks können bei schlechter/falscher Konfiguration “verhungern”
Standard Scheduling in FreeRTOS
preemptive
Round-Robin mit Prioritäten
Idle-Task Prio = 0
Höhere Prio = frühere Ausführung
Tickrate für Time-Slicing (1ms, 1000Hz)
FreeRTOS: Memory
Heap
NUR für FreeRTOS selbst
globaler Speicher für dynamische Allokationen (z.B. Tasks, Queues, Semaphoren, Timer, …)
kann/muss manuell gesetzt werden
Stack:
Speicher pro Task
speichert z.B. lokale Variablen
Kann dynamisch erzeugt werden (aus dem Heap)
Kann statisch pro Task angelegt werden (dynamische Ergänzung dann nicht mehr möglich)
Overflow Detection (Memory)
Heap:
keine automatisierte Overflow Detection
Wenn nicht genug verfügbar » Fehler
Muss dann manuell erhöht werden
Gründe: zu kleiner initialer Heap-Speicher eingestellt, Fragmentierung des Heaps (» muss zusammenhängend verfügbar sein), zu viele dynamische Tasks ohne statischen Speicher, Stack-Overflow in den Heap-Speicherblock
Stack:
Muss extra aktiviert werden (config: CHECK_FOR_STACK_OVERFLOW)
Stack Pointer Limit Check:
Prüft ob der aktuelle Stack Pointer auf eine Adresse außerhalb des zugewiesenen Bereiches zeigt
Pattern check at the end of the stack:
FreeRTOS spezifisch
Am Ende des Stack Speicherbereiches wird ein Füllmuster gespeichert (Dummy)
Falls das Füllmuster überschrieben wird » Stack Overflow (Checks bei jedem Task Switch)
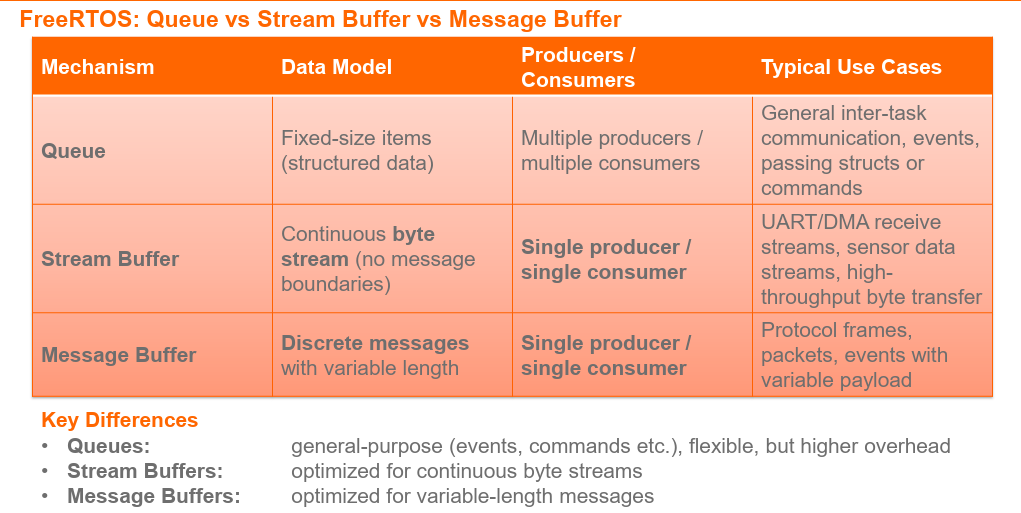
Kommunikationsmechanismen / Datenübertragung
Queue:
FIFO, mit Option nach vorne zu setzen
Fixe Kapazität (n Elemente)
Fixe Elementgröße » Länge (n characters)
Nachrichten werden in den Buffer kopiert, Übergabe von Pointern ist aber möglich (dadurch auch größere Elemente)
Mehrere Sender & Nutzer möglich
bekannte Priorisierung
Nachteil: großer Overhead
Stream Buffer:
Task2Task & ISR2Task
Keine feste Datenlänge
kontinuierlicher Datenstrom (byte für byte)
Sender kopiert Daten in den Buffer, Empfänger kopiert aus dem Buffer
Einzelner Sender & Empfänger (» nicht für mehrere Teilnehmer geeignet)
Anwendung: Sensorübertragungen, Übertragungen mit hohem & kontinuierlichem Datendurchsatz
Message Buffer:
Sendet diskrete Nachrichten auf einmal (nicht byte für byte)
Variable Nachrichtenlänge (kein Limit)
Einzelner Sender & Empfänger (» nicht für mehrere Teilnehmer geeignet)
Anwendung: Pakete und variablen mit variabler Nutzlast
Unterschied Delay Arten
vTaskDelay: Task geht in “Blocked” und gibt die CPU frei, andere Tasks können weiter laufen
osDelay: CMSIS-Wrapper (FreeRTOS) für vTaskDelay » gleiches Verhalten
HAL_Delay: Nutzt “Busy-Wait”, Task bleibt Running » niedriger priorisierte Tasks sind geblockt
Unterschied: UART & USART
UART: nur synchrone Kommunikation
keine Taktleitung
benötigt die exakte Geschwindigkeit (Baud Rate)
USART: synchrone und asynchrone Kommunikation
verwendet zusätzliche Taktleitung mit Clock
Baud Rate daher nicht zwingend notwendig
Unterschied: UART & huart2
UART: Hardwareprotokoll, physische Übertragung
huart2: Softwarehandle » Softwareseitige Implementierung von UART, Erlaubt Steuerung des UART Protokolls
Synchronisationswerkzeuge
Benötigt für Zugriff auf geteilte dynamische Variablen » Task braucht immer den aktuellen Zustand
Binary Semaphores:
Beschränkt Zugang zu geteilten Ressourcen
Nutzt Zustandsvariable: 0/1 » unavailabe/availabe
Eine Task kann nur in Zustand 1 auf die Inhalte zugreifen
Eine Art Ampel » Zustandsvariable
Alle Tasks müssen warten, bis die Ressource wieder freigegeben ist
danach Zugriff abhängig von Priorisierung
Führt teilweise zur Invertierung der Prioritäten » Höher priorisierte Tasks müssen auf niedriger priorisierte warten
Low Task hat die Semaphore, H will die Semaphore aber blockiert da schon vergeben
Medium Task unterbricht die Low Task, da sie eine höhere Priorität hat
High wartet auf die Semaphore
Mutex (Mutual exclusion):
Eine Art Schlüssel » Besitzrecht: es ist klar wer das Mutex hat
Funktionsweise wie Binary Semaphore, ABER:
kann kurzzeitig die Priorität der aktuellen Task erhöhen, wenn eine höherpriorisierte Task Zugriff braucht
» Verhindert Invertierung der Priorität
Low Task hat die Semaphore, H will die Semaphore aber blockiert da schon vergeben
Low Task wird auf höchstmögliche Priorität gesetzt und schnellstmöglich beendet
Medium Task wird daher nie ausgeführt und kann Low Task nicht unterbrechen
Counting Semaphores:
Ähnlich zu Mutex/Binary Semaphores
Kann genutzt werden, um den Zugriff zu einem Pool identischer Variablen zu managen
» z.B. 3x identische Queues/UART Channel
Hat einen Counter (hier c=3)
Nimmt eine Task den Ressourcenpool in Anspruch, sinkt c um 1 (c=c-1) bis zum Abschluss der Task
Erst wenn der Counter auf 0 steht, wird der Zugang verwehrt
quasi rote Ampel
Was ist HAL?
HAL: Hardware Abstraction Layer
Schnittstelle zwischen der Software-Schicht und physischen Hardware
Ersetzt komplizierte Register-Operationen durch einfache Funktionsaufrufe
verbessert Portabilität, Wiederverwendbarkeit und Skalierbarkeit
Task Notification
Ersatz für Kommunikationsmechanismen wie Queues, Semaphores oder Event Groups
Vorteil: schneller & speichersparender (RAM), kein separates Objekt nötig (kein Overhead)
Eine Task A oder ein Interrupt können ein Wecksignal für eine Task A senden (z.B. unblock)
Wichtig: Nur an eine Task gleichzeitig!
Welche Task nach Senden läuft (Task 2 Task). entscheidet die Priorität
A sendet an B
» A>B: A läuft zu Ende vor B
» B<A: B läuft vor A
» B=A: B startet im nächsten Time-Slice
Event Groups
Zusammenstellung aus Event Flags
1 Event Flag = 1 Bit
Ein Task kann geblockt werden, bis ein bestimmtes Event oder mehrere gleichzeitig (Kombination) eintreten
Kann RAM sparen, indem eine Event Group mehrere Binary Semaphores ersetzt.
Wofür steht UML
Unified Modeling Language
Was zeigt ein UML State Diagramm?
Verschiedene Statusmöglichkeiten des Systems
Visualisiert den Wechsel zwischen Zuständen
Event Driven

Was zeigt ein System Context / System Component Diagramm?
Es zeigt die Systemgrenzen und wie das System darüber hinaus mit seiner Umwelt interagiert
Zeigt Schnittstellen
Was sind "Building Blocks" im Kontext von Software Architecture Modeling?
Wiederverwendbare, in sich geschlossene Verhaltens- oder Dateneinheiten
z. B. Treiber, Protokollstack, Regelalgorithmus
die interne Komplexität verbergen und über eine klare Schnittstelle verfügen.
Bildbar durch Dekomposition des Systems » kleine, abgegrenzte Einheiten » Beziehungen miteinander ermitteln
Typische Layers in Embeeded Architekturen
Software und Hardwarearchitektur sollten getrennt voneinander entwickelt werden
» Eine unabhängige Softwarearchitektur ermöglicht einfachere Updates, Skalierung und Funktionserweiterungen.
Application Layer:
User-Level Funktionen, von der Hardware größtenteils entkoppelt
Middleware:
Stellt häufig genutzt Services wie Sicherheitsfunktionen, Dateisysteme oder Kommunikationsprotokolle zur Verfügung
RTOS:
Managed multitasking, CPU-Scheduling, Synchronisierung und zeitkritische Operationen
Drivers:
Low-level Code, der die direkte Hardwareperipherie steuert: UART, SPI, ADCs
Hardware:
Der Mikrocontroller selbst, RAM, Sensoren Aktoren
Vorteile:
modularer Aufbau, Umstiegsmöglichkeit (Hardware), Skalierbarkeit, Wiederverwertbarkeit für neue Projekte
Was ist DevOps?
Verbindet Softwareentwicklung & IT-Betrieb zur Bereitstellung von Applikationen
» War in der Vergangenheit oft getrennt voneinander
Ziel:
Effizient, Geschwindigkeit, Sicherheit, Integrationskonflikte vermeiden
Was ist CI/CD?
» Continuous Integration & Continuous Delivery/Deployment
CI:
Entwickler mergen Code in regelmäßigen Abständen
Code wird automatisch gebaut, & getestet
CDelivery:
Software ist IMMER in einem ausführbaren Zustand
CDeployment:
Jede Änderung die automatische Tests besteht wird automatisch in die Produktionsumgebung ausgerollt
Was ist eine Smoke Test
Test, der grundlegende Systemfähigkeiten testet. Erst nach bestehen des Smoke Tests finden detaillierte Tests statt.
Jobs & Stages
Job:
Code kompilieren
Tests ausführen
Deployment auf Server
» Jobs sind in mehrere Stages aufgeteilt
z.B. Stage 1: Build
Stage 2: Test
Stage 3: Deploy
Ausführung von Stages ist immer sequentiell
Jobs können auch in einer Stage parallel laufen
Schlägt ein Job fehl, wird die gesamte Pipeline abgebrochen
DevOps Workflow
Planung » Anfroderungen & Features definieren
Entwicklung » Schreibe Tests und integriere Code Änderungen
Continuous Testing » Automatische Tests um Qualität sicherzustellen
Release » Für Release vorbereiten
Deploy » Produkt in Produktionsumgebung einsetzen
Operate » Überwache Systemperformance
Monitor & Feedback » Sammeln von Laufzeitdaten & Nutzerrückmeldungen
Alles im Loop
Docker Container
Leichtgewichtige Umgebung um Applikationen isoliert auszuführen
Erlaubt konsistente und reproduzierbare Ergebnisse
Dockerfile: Rezept/Bauanleitung
Docker Image: fertiges Paket mit allen notwendigen Abhängigkeiten (Dient als Template)
read only
Container: Eine oder mehrere laufende Instanz eines Docker Images
Artifacts
Von Jobs erzeugt
Endprodukte eines Build- oder Testprozesses
Produziert durch CI/CD Jobs
Können zum Datenaustausch zwischen Jobs & Stages genutzt werden
In der Regel nur temporäre Speicherung
Test Driven Development (TDD)
Tests werden VOR dem eigentlichen Code geschrieben
Entwickelter Code muss diese Tests dann erfüllen
Code Coverage
Anteil an Code/Funktionen, der durch Tests geprüft wird
Externe Tools wie gcovr automatisieren die Anzeige
Ziel: meist >80%
Arten von Tests (Teststufen)
Unit Testing:
Isolierter Test einzelner Funktionen ohne Hardwareabhängigkeiten
Ziel: Code- & Logikfehler finden + Randfälle testen
Integration Testing:
Synergie aller Layers untereinander:
Kombination von Softwaremodulen
Hard- & Softwaresynergie
System Testing:
Gesamtsystem
Prüft funktionale & non-funktionale Anforderungen
Performance & Robustheit werden getestest
Acceptance Testing:
Nutzererwartung (nicht technisch)
Werden Stakeholder-Erwartungen erfüllt
z.B. durch Alpha-/Beta-Testing
Unit Testing
Einzelne C-Funktionen testen: Logic + Randfälle
Rückgabewerte prüfen
z.B. mit Unity Framework
Eigenschaften eines guten Unit Tests:
sehr schnell
deterministisch
vollautomatisiert
Hardwareunabhängig
isoliert (unabhängig von anderen Units)
Stubs & Mocks
Werden benötigt um Hardwareabhängigkeiten während eines Unit-Tests zu imitieren (z.B. Buttondruck)
Stubs:
Liefert bei Aufruf vordefinierten Rückgabewert
z.B. ADC-Lesefunktion liefert vordefinierten Wert, statt tatsächlich auf die Hardware zuzugreifen
üblicherweise in Form einer neuen Funktion mit gleichem Namen
Mocks:
Prüft eine Interaktion mit der aufgerufenen Funktion
z.B. nicht nur wurde die Funktion aufgerufen, sondern wurde sie auch mit dem richtigen Parameter aufgerufen
oder wie oft wurde die Funktion aufgerufen?
z.B. wird der richtige PIN auf HIGH gesetzt wenn Fall A eintritt?
eig. ein Stub mit Extraschritten
CMake & Unity ermöglichen automatische Mock oder Stub Generierung
Implementierungsmöglichkeiten Stubs & Mocks
Compiler Flags:
ifdef BUILD_TEST » include test_fake
else » include normal
Weak Attribut:
Weak Attribut für Funktionsdeklaration innerhalb des echten codes verwenden
Testfunktionen überschreiben diese dann im Test (gleicher Name)
Link-time selection
Unterschiedliche Binaries für den Build:
1. Produktionscode
2. Testcode
In der Testumgebung Testfiles statt echte Files für den Build linken