2: AI Technology Foundations 1 (Discriminative AI Technology)
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/19

Earn XP
Description and Tags
Supervised/Unsupervised Machine Learning, Reinforcement Learning
20 Terms
Was versteht man unter Machine Learning?
Sammelbegriff für Techniken, bei denen Computersysteme das Lernen von Mustern und Regelmäßigkeiten anhand von Beispieldaten automatisieren
Fähigkeit von Systemen, aus trainingsspezifischen Daten zu lernen, um den Prozess des Aufbaus analytischer Modelle zu automatisieren und damit verbundene Aufgaben zu lösen
Besteht aus:
Shallow machine learning:
klassiche Machine learning algorithms (ohne neuronale Netze)
können keine hierarchischen Strukturen lernen
AI neural networks (einfache neuronale Netze):
1-2 Hidden Layers → nicht tief genug, um als Deep Learning zu gelten
Deep Learning: Neuronale Netzte mit vielen Schichten → lernen hierarchische Merkmalsrepräsentationen
=> Computer lernen ohne expliziert programmiert zu werden

Wie funktioniert Machine Learning?
Ziel: Generalisierung der Erfahrung auf eine Weise, die es ermöglicht, die Leistung bei der Aufgabenbewältigung zu verbessern
nicht einfach Daten auswendig lernen, sondern aus den Daten allgemeine Regeln ableiten → Übertragen des aus Trainingsdaten Gelernten auf neue, unbekannte Daten
Gegeben:
Task T: Computersystem lernt aus Erfahrungen in Bezug auf eine bestimmte Klasse von Aufgaben (T) → Was soll das System tun?
z.B.: T = Erkennen, ob eine E-Mail Spam ist
Performance Measure P (Leistungsmaß): Computersystem lernt aus Erfahrungen in Bezug auf eine bestimmte Klasse von Aufgaben (T), wenn seine Leistung bei den Aufgaben in T, gemessen an P, sich durch Erfahrung E verbessert → Wie gut erfüllt das System die Aufgabe?
z.B.: P = Anteil korrekt klassifizierter E-Mails (Vor dem Lernen:75%; Nach dem Lernen: 95%)
(training) experience E: Computerprogramm lernt aus Erfahrungen (E) → Daten/Beobachtungen, aus denen das System lernt
z.B. Trainingsdaten, historische Messwerte, Nutzerinteraktionen
z.B. 100.000 E-Mails, die bereits als “Spam” oder “Nicht-Spam” klassifiziert wurden)
Welche drei Arten von Machine Learning gibt es?
Supervised Machine Learning
Unsupervised Machine Learning
Reinforcement Learning
=> Beschreiben die Art des Lernens (Lernparadigmen)

Erkläre das Supervised Machine Learning mit ihren Anwendungen.
Supervised Machine Learning:
Ziel: Lernen einer allgemeinen Regel/Modell, das die Eingabe auf die Ausgabe abbildet
Modell versucht Zusammenhang zwischen Eingabevektor und Zielvektor zu lernen, um für neue Daten korrekte Vorhersagen treffen zu können
Algorithmus erhält Trainingsdaten (enthalten Features und Labels) zum lernen
Eingabedaten (Features): z.B. Alter, Einkommen, Wohnort
Zielwert (Label) → die richtige Antwort
Anwendungen: Klassifikation, Regression
=> richtige Lösung ist bereits bekannt, Lernen aus Lösungen

Erkläre Klassifikation als Anwendung des Supervised Machine Learnings ink. Klassifikationsbewertung.
Methode erklärt ein dichotomes oder kategoriales Merkmal mit Hilfe verschiedener unabhängiger Variablen
Vorhersage hat eine feste Anzahl an Kategorien/Gruppen → Zu welcher Kategorie gehört ein Objekt? z.B. Spam/Nicht-Spam
Objekte werden anhand von ihren Merkmalen einer Klasse zugeordnet
Dichotome-Merkmale werden durch zwei gegensätzliche Werte beschrieben
z.B. “gut” und “schlecht”, “Ja” und “Nein”, “Spam” und “Nicht Spam”
Kategoriale Merkmale haben einen zählbaren Wertebereich
z.B. Menge der Primärfarben mit den Werten “rot”, “gelb” und “blau”, Feedback-Skalen wie “sehr glücklich”, “glücklich”, “unglücklich” → Merkmal kann nur bestimmte Kategorien annehmen
z.B. Wetter-Klassen: sonnig, bewölkt, regnerisch, schneereich
z.B. Köpper Climate Classifikation:
Eingabedaten: Temperatur, Niederschlag, Luftfeuchtigkeit
Ausgabe: Klimaklasse A,B,..,E (Tropisch, Trocken, Polar-Klima,…)

Erkläre die Klassifikationsbewertung der Klassifikation.
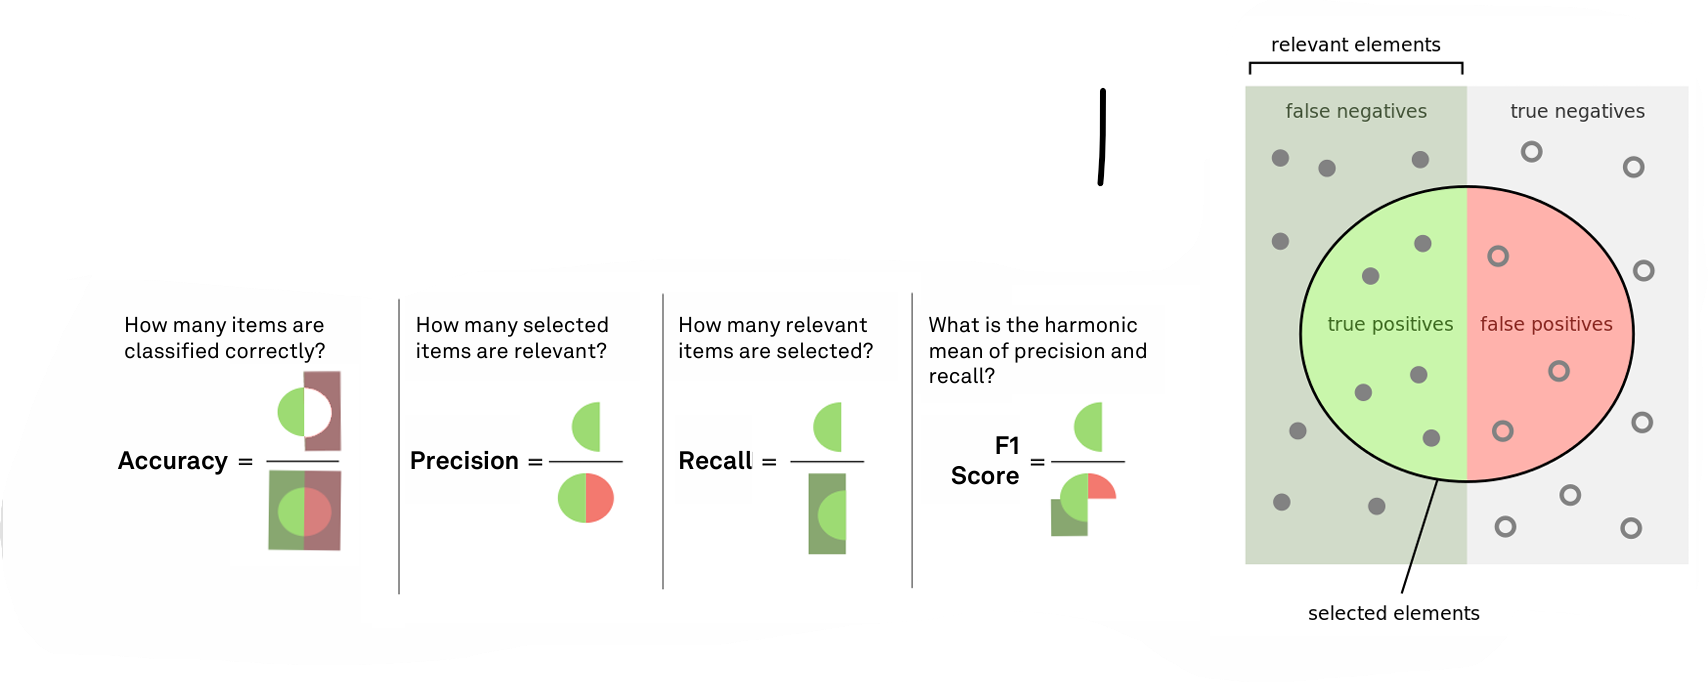
Klassifikationsbewertung durch:
Messverzerrungen vermeiden durch Verwendung mehrerer Metriken gleichzeitig (Accuracy, Precision,…)
Accuracy (Genauigkeit) = korrekte Vorhersagen/alle Vorhersagen (Je höher Accuracy, desto besser die Klassifikation)
weitere KPIs:
Precision = TP/(TP+FP) → je höher, desto weniger Fehlalarm, weniger False Positive (z.B. wenig Nicht-Kranke werden falsch diagnostiziert)
Recall = TP/(TP+FN) → Je höher, desto weniger übersehene Fälle, weniger False Negatives (z.B. wenig Kranke werden übersehen)
F1-Score = TP/(FN+TP+FP) → Je höher, desto weniger übersehene Fälle (hoher Recall) und weniger Fehlalarm (hohes Precision)
Allgemeingültigkeit durch Kreuzvalidierung berücksichtigen
Ziel: Generalisierung auf neue Daten, um Overfitting (Auswendiglernen von Trainingsdaten) zu vermeiden
Kreuzvalidierung: mehrfaches Aufteilen der Daten in verschiedene Trainings- und Testmengen
Klassenungleichgewichte durch gewichtete Metrik berücksichtigen
Klassenungleichgewicht = Klassen treten nicht gleich häufig auf
Problem: Mehrheitsklasse dominiert Bewertung (z.B. 95% Accuracy, da alles als “normale Mail” kategorisiert wurde)
Lösung: seltene Klassen erhalten ein höheres Gewicht
Erkläre Regression als Anwendung des Supervised Machine Learnings.
statistisches Verfahren zur Bestimmung der Beziehung zwischen einer abhängigen Variable und verschiedenen unabhängigen Variablen
unabhängige Variablen (Features): Einflussgrößen (z.B. Wohnfläche, Zimmeranzahl)
abhängige Variable (Target): Zielwert (z.B. Hauspreis)
Prognose als begründete Vorhersage eines zukünftigen Zustands basierend auf Messungen, Erfahrung oder Simulation
eine Vorhersage hat unbegrenzte Anzahl an numerischer Ergebnisse (kontinuierlicher Ergebnisraum) → Welchen Zahlenwert wird etwas wahrscheinlich haben? (z.B. Hauspreis)
Regressionsanalyse bestimmt eine funktionale Gleichung als die beste Annäherung, um die abhängige Variable aus den unabhängigen Variablen zu bestimmen
z.B. Global Surface Warming:
Eingabedaten: CO2-Konzentration, Sonneneinstrahlung, historische Temperaturdaten
Ausgabe: + 1,8°C → Vorhersage eines konkreten Temperaturwertes

Erkläre das Unsupervised Machine Learning mit ihren Anwendungen.
Algorithmus muss selbst die Strukturen in den Eingaben finden
Ziel: richtige Lösung aus gegebenen Daten erkennen (verborgene Muster erkennen) oder zur Unterstützung eines supervised Ansatzes beitragen (Extraktion relevanter Merkmalen (Features)
Anwendungen: Clustering, (Dimensinally Reduction)
→ Richtige Lösung ist nicht bekannt, Lernen aus Muster
Erkläre Clustering als Anwendung des Unsupervised Machine Learnings.
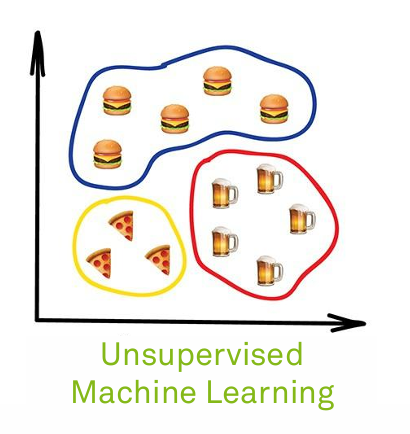
algorithmische Methode
erkennt Ähnlichkeiten zwischen Datenelementen (Objekte) und fasst diese zu Clustern zusammen (Mustererkennung)
Vorhersage hat eine variable Anzahl von Kategorien/Gruppen
Eingabevektor: z.B. Alter, Einkommen Kaufverhalten
Ausgabevektor: Gruppe A:junge Kunden, Gruppe B: Familien → Gruppe war vorher nicht bekannt
z.B. Wetter: Algorithmus bildet Cluster mit ähnlichen Datenpunkten aber sagt NICHT, was das Cluster bedeutet (menschliche Intepretation)
Bewertungskriterien für die Anzahl der Cluster

Erkläre Dimensinality Reduction als Anwendung des Unsupervised Machine Learnings.
Ziel: Reduktion der Anzahl der Merkmale (Features/Dimensionen), ohne zu viele wichtige Informationen zu verlieren
Strukturen werde gesucht
Zweck: Reduzierung von Rechenkosten und Overfitting, Erleichtern der Visualisierung, Datenvorbverarbeitung für Machine Learning Anwendungen
Erkläre Ensembles Learning als kombinatorischer Ansatz verschiedener Anwendung des Machine Learnings.
Ziel: Kombinieren verschiedener Modelle, um besseres Gesamtmodell/Vorhersagen zu erhalten
Zweck: Vorhersageleistung verbessern, Überanpassung (Overfitting) reduzieren, Robustheit der Vorhersagen über verschiedene Datensätze hinweg erhöhen (Modell bleibt auch bei neuen/veränderten Daten zuverlässig)
Ensenble durch Mittelwertbildung: z.B. Modell A: 40, Modell B: 42, Modell C:41 → (40 + 42 + 41)/3 = 41 = Vorhersage:41
häufig bei Regression (Ausreißer werden geschwächt)
Ensemble durch gewichtete Abstimmung: A: Regen, gewicht:0,2 , B: Regen, gewicht:0,2, C:Sonne, gewicht: 0,6 = Sonne = Vorhersage: Sonne
häufig bei Classification (Berücksichtigung, das unterschiedliche Modelle unterschiedlich gut sind)
Verfahren:
Bagging: z.B. Random Forest → Zusammenarbeit vieler Entscheidungsbäume
Boosting: neue Modelle konzentrieren sich auf die Fehler der vorherigen Modelle
Stacking: Mehrere Modelle erzeugen Vorhersagen, die dann von einem weiteren Modell kombiniert werden
werden oft für Supervised Learning benutzt (Klassifikation, Regression)
Erkläre Reinforcement Learning als eine Art des Machine Learning.
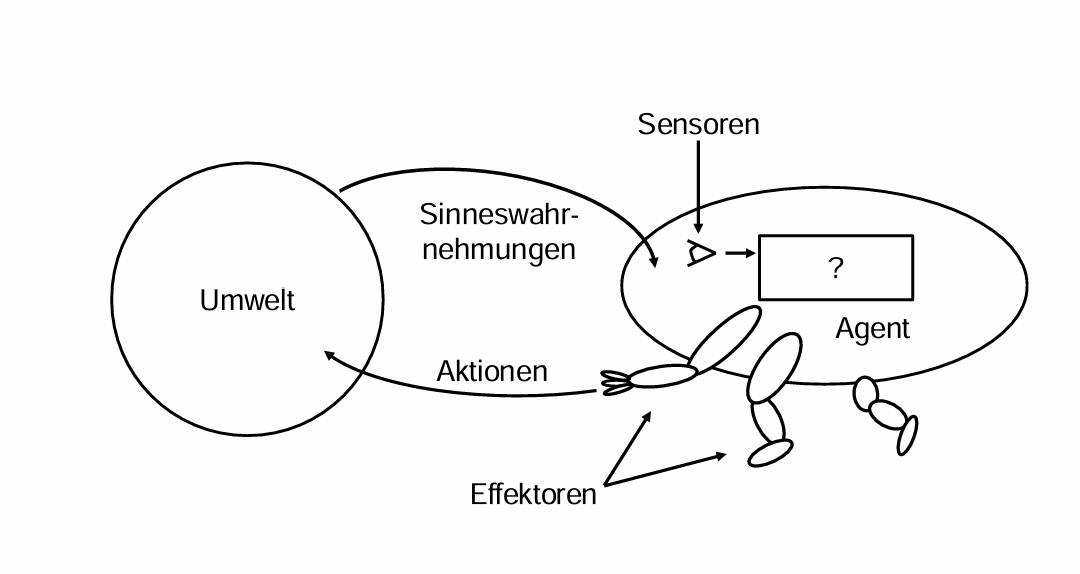
Erkennung von Maßnahmen in einer bestimmten Situation, um eine Belohnung zu maximieren
Zielvektor muss durch ausprobieren herausgefunden werden
Abfolge von Zuständen (Zustand = z.B. aktuelle Stellung aller Figuren) und Aktionen sind gegeben
Agent = lernende System
Agent nutzt diese, um mit seiner Umgebung (z.B. Schachbrett) zu interagieren → Nach jeder Aktion erhält der Agent Feedback
z.B. Schachspielen: guter Zug → Belohnung, schlechter Zug → Bestrafung => Agent lernt schrittweise eine optimale Strategie
→ Lösung ist unbekannt, Lernen aus Belohnungen
Was sind künstliche neuronale Netzwerke?
= Klasse von Rechenmethoden, die lose von der Funktionsweise des menschlichen Nervensystems inspiriert sind
sie können als gerichtete Graphen beschrieben werden
Knoten = künstliche Neuronen
Neuronen = übertragen die gewichteten Signale
Kanten = Verbindungen zwischen den Neuronen, besitzen Gewichte
sind in Schichten organisiert
Eingabeschicht
Ausgabeschicht
Verborgene Schichten → Verantwortlich für die nicht-lineare Abbildung zwischen Ein- und Ausgabe
Aktivierungsfunktion = bestimmt, wie das aggregierte Eingangssignal eines Neurons in ein Ausgangssignal umgewandelt wird
entscheidet über die Aktivierung des Neurons → wenn Gewicht des Eingangssignals stark genug ist, erzeugt Neuron ein entsprechendes Ausgangssignal verarbeitet
=> Nicht alles (z.B. Neuronen, Schichten) können gelernt werden → Sie müssen als Hyperparameter festgelegt werden
Erkläre die Struktur eines neuronalen Netzes.
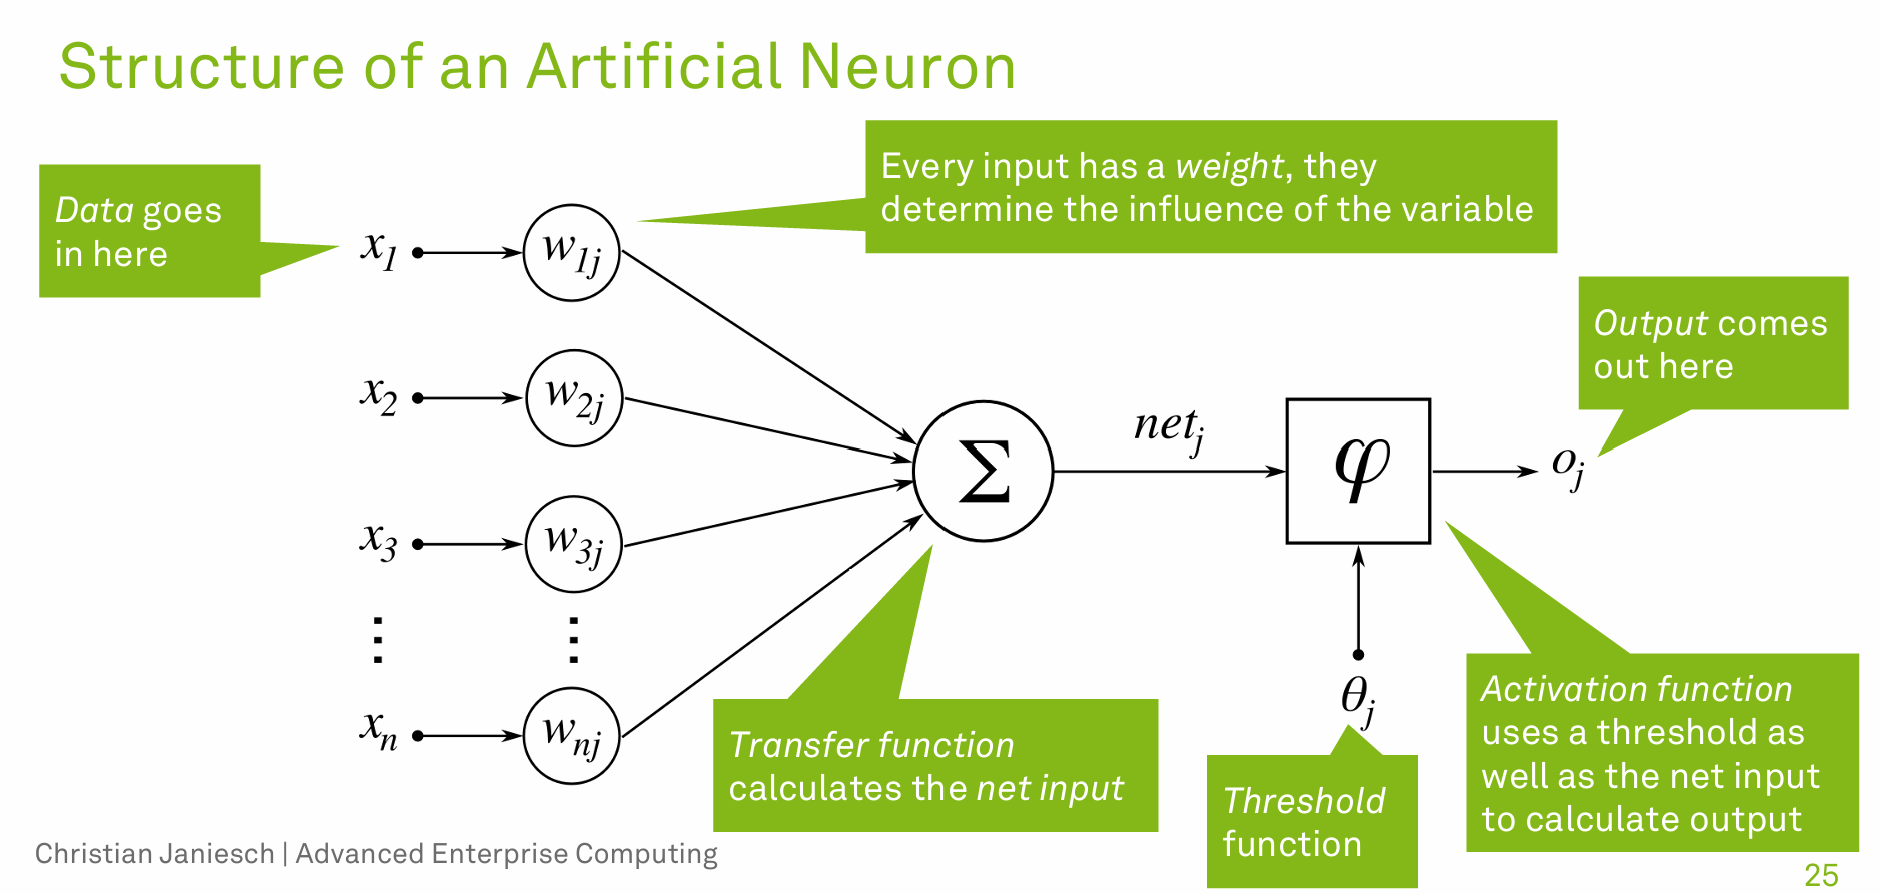
Eingabeschicht: Daten gehen in ein Neuron ein
Jedes Dateninput hat ein Gewicht, welches den Einfluss der Variable (Neuron) im Netz bestimmt
z.B. drei InputNeuronen: IN-1: Temperatur = 20; IN-2: Wind = 5; IN-3: Regen = 1)
Die drei Eingaben (Input Neuronen laufen jetzt in ein Neuron des Hidden layers:
Transfer function: berechnet alle Signalgewichte der eingehenden Neuronen und summiert sie (net input)
z.B. 20×0,5; 5×0,3; 1×0,8 → net = Summe aller drei
Threshold function: erhält das net input und fügt ein bias hinzu, damit das Neuron flexibler lernen kann
Activation function: Nutzt das net output der transfer function sowie des threshold function → Entscheidet, was aus dem berechneten Wert werden soll
berechnet Output des Neurons und leitet es an das output layer

Ordne Deep Learning in das Konzept der Künstlichen Neuronen ein.
Bestehen aus mehr als einen hidden layer
enthalten fortgeschrittene Neuronen im Gegensatz zu neuronalen Netzwerken
fortgeschrittene Operationen (z.B. Faltungen)
mehrere Aktivitäten in einem Neuron
können automatisiertes Feature-Lernen, d.h. erhalten Rohdaten und können automatisch eine Repräsentation entdecken, die für die jeweilige Lernaufgabe benötigt wird
Merkmalsrepräsentationen = die verschiedenen hidden layer lernen Merkmale unterschiedlicher Komplexität →
z.B. Hunde-Bilderkennung: Erster hidden layer lernt Kanten, Linien; zweiter Layer lernt Kreise, Konturen; dritter Layer lernt Augen, Ohren; spätestes Layer erkennt ganzen Hund
Beschreibe den Unterschied zwischen White-Box und Black-Box Algorithmen.
White Box = von Menschen grundsätzlich interpretierbar
z.B. einige Shallow ML algorithms (flache ML)
Black Box = vom Menschen nicht nachvollziehbar
fortgeschrittene ML-Algorithmen (z.B. Deep Learning)
Nenne verschiedene Arten von ML in Deep Learning.
Objekterkennung
z.B. Hund erkennen mittels supervised + deep Learning
Uber-System nutzt Personenerkennenung
Bildwiederherstellung (z.B. Bild schärfen)
Brettspiel spielen (z.B. Schach mittels Deep Learning + Reinforcement Learning)
Uber: Personenerkennung auf der Straße aus Distanz
→ Neuronale Netze sind sehr flexible und können verschiedene Architekturen erstellen, um unterschiedliche Problemarten zu lösen
Beschreibe den Zusammenhang zwischen AI, ML-Algorithmen, Arten von ML (Lernparadigmen) und Klassen von AI Algorithmen.
AI: Oberbegriff für alle Systeme, die Aufgaben ausführen, die normalerweise menschliche Intelligenz erfordern
ML-Algorithmen: klassische ML- Algorithmen, einfache AI neuronale Netzwerke, fortgeschrittene neuronale Netzwerke
Arten von ML = Lernart des verwendeten Algorithmuses
Supervised-ML: Klassifikation, Regression
Unsupervised-ML: Clustering, (Dimensional reduction)
Reinforcemt Learning
Klassen von AI-Algorithmen = Modellklassen/ML-Algorithmus, womit gelernt wird
Entscheidungsbäume, Random Forest, Support Vector Machine, Lineare Regression, einfache Neuronale Netzwerke, Deep Learning
z.B. Kann ein Entscheidungsbaum für Klassifikation (supervised) aber auch für Regression (supervised verwenden)
Komplexität der Klassen:
Shallow Learning: klassische ML-Algorithmen + einfache neuronale Netze
fortgeschrittene neuronale Netze (Deep Learning)
→ ML Algorithmen <=> Klassen von AI-Algorithmen <=> Modell/Algorithmus womit gelernt wird
Wofür wird das Tool “Trenserflow Playground” verwendet?
= zur Visualisierung neuronaler Netze
Beobachtung von Neuronen, Hidden Layer, Gewichte, Trainingsfortschritt
Verständnis über: wie Netzwerke lernen, wie mehr Hidden Layers die Modelleistung beeinflussen, wie Aktivierungsfunktionen wirken
Erkläre das Trade-Off zwischen Performance und Interpretierbarkeit von ML-Modellen.
Trade-Off:
Manche Modelle sind gut verständlich aber weniger leistungsfähig (z.B. Entscheidungsbaum) → White Box
Manche Modelle sind leistungsfähig aber schwer nachvollziehbar (z.B. Deep Learning) → Black Box
Praxis: Es gibt Fälle, in denen:
interpretierbare Modelle sehr gut funktionieren
Black-Box-Modelle keinen großen Vorteil bringen
→ Es gibt nicht nur mit Black-Box Modellen hohe Performance
Bezug zu Explainable AI: Kann man leistungsfähige Modelle nutzen und sie trotzdem verständlich machen?
