Begreper - Pugg
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/78

There's no tags or description
Looks like no tags are added yet.
79 Terms
Tverrsnittsdata
data om forskjellige individer eller fenomener, hvor alle er observert på samme tid
ønsker å studere forskjellene mellom individene/fenomenene på det gitte tidspunktet
Tidsseriedata
data om samme individ eller fenomen, over tid
ønsker i studere utviklingen til det ene individet/fenomenet over tid
Paneldata
data om forskjellige individer/fenomener, over en tidsperiode
ønsker å studere forskjellene i utviklingen til flere individer/fenomener over tid
en blanding av tverrsnitts- og tidsseriedata
Populasjon
de objektene vi ønsker å studere eller finne noe ut om
det man tar et utvalg fra
Utvalg
en valgt del av populasjonen
bør være representativ for populasjonen for å få gode statistiske resultater av analysene
Representativt utvalg
et utvalg som kan brukes til å beskrive noe om hele populasjonen
desto større utvalg som andel av populasjonen du velger å gjøre analysene på, desto mer sannsynlig er det for at utvalget er representativt
Målenivåer
kategorier variabler kategoriseres innenfor
beskriver hvordan en variabel måles, og hvilke typer verdier og matematiske operasjoner det er meningsfullt å bruke på variabelen
Nominalnivå
verdiene er forskjellige
kan ikke si noe om forholdet mellom verdiene
kan ikke rangeres
eks: tlfnr., kjønn

Ordinalnivå
verdiene er forskjellige og kan rangeres
ikke nødvendigvis konstant intervall mellom verdiene
eks: militærrang, pallplassering

Intervallnivå
verdiene er forskjellige, kan rangeres og det gir mening å tolke avstand
det er like langt mellom verdiene (konstant intervall mellom verdiene)
eks: årstall, temperatur

Forholdstallsnivå
verdiene er forskjellige, kan rangeres og det gir mening å tolke avstand og forholdet mellom verdiene
verdiene har også et naturlig nullpunkt
eks: pris, avstand
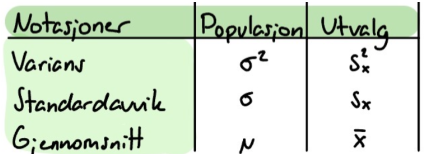
Varians
et mål på hvor mye observasjonene varierer rundt gjennomsnittet
måler spredningen i et datasett
beregnes som gjennomsnittet av de kvadrerte avvikene fra gjennomsnittet

Standardavvik
kvadratroten av variansen
viser hvor stor spredning observasjonene har rundt gjennomsnittet, målt i samme enhet som variabelen

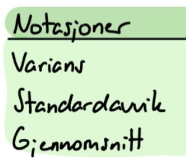
For både populasjon og utvalg
Kovarians
et mål på hvordan to variabler varierer i takt med hverandre
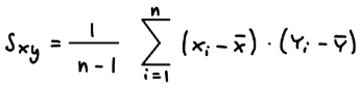
Korrelasjon
en måte å tallfeste hvor sterk sammenhengen mellom to variabler er
mellom -1 og 1, hvor:
-1 representerer perfekt negativ korrelasjon
1 representerer perfekt positiv korrelasjon
0 representerer ingen samvariasjon

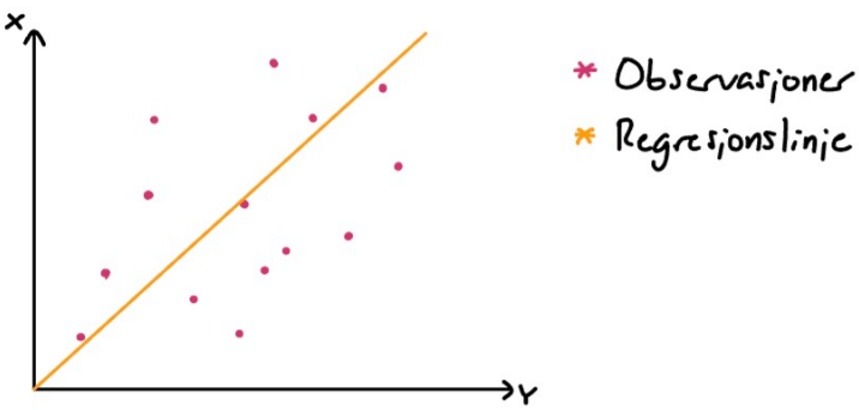
Lineær regresjon
Korrelasjon tallfester sammenhengen mellom to variabler
Lineær regresjon viser sammenhengen mellom to variabler med en lineær funksjon
Den enkle regresjonsmodellen
Undersøker i hvilken grad endringer i X klarer å forklare endringer i Y
Modellen har bare én forklaringsvariabel (X)

Den sanne modellen
Vi tenker oss at denne modellen har produsert all dataen vi har å analysere
Det er denne modellen man forsøker å gjenskape når man estimerer multiple regresjonsmodeller
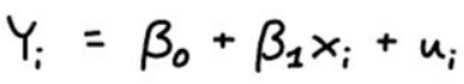
Den estimerte modellen
Modellen vi beregner ut i fra dataen vi har
Skrives med hatter over bokstavene for å representere at det er et estimat på den sanne modellenN

Anslagsfeil/Residual
Feilleddet i den estimerte modellen kalles for anslagsfeilen eller residualet
Det er forskjellen mellom data og modellens estimat for den samme observasjonen i

Koeffisient
en tallverdi som angir størrelsen og retningen på sammenhengen mellom en forklaringsvariabel og den avhengige variabelen i en regresjonsmodell, gitt at de øvrige forklaringsvariablene holdes konstante
Minste kvadraters metode (OLS)
en metode for å estimere koeffisientene i en regresjonsmodell ved å minimere summen av de kvadrerte residualene, altså forskjellene mellom observerte og predikerte verdier av den avhengige variabelen
vi bruker OLS til å finne den lineære funksjonen

Hva sier verdien til residualen oss?
Lite residual --> modellen estimerer presist
Stort residual --> modellen estimerer upresist
Residual kvadratsum (RSS)
residual sum og squares
summen av alle residualene kvadrert
ved å kvadrere residualene får vi bare positive tall og unngår at positive og negative residualer kansellerer ut hverandre

BLUE
Den beste lineære forventningsrette estimatoren, som har lavest vareians blant alle lineære forventningsrette estimatorer
OLS er BLUE når Gauss-Markov-forutsetningene (SLR.1-SLR.5) er oppfylt
Estimat
en beregnet verdi fra et utvalg som brukes til å anslå en ukjent populasjonsparameter
Estimator
en statistisk metode eller formel som brukes til å beregne et estimat av en ukjent populasjonsparameter basert på utvalgsdata
en estimator er en tilfeldig variabel fordi verdien avhenger av hvilket utvalg som trekkes
Forventningsverdi
Det teoretiske gjennomsnittet til en tilfeldig variabel, beregnet som et vektet gjennomsnitt av alle mulige verdier, der hver verdi vektes med sannsynligheten for at den inntreffer
Forventningsverdi = 0
Det teoretiske gjennomsnittet til en tilfeldig variabel er null
Positive og negative verdier veier dermed opp for hverandre i gjennomsnitt
SLR.1
Modellen skal være lineær i regresjonskoeffisientene
Det skal være et lineært forhold mellom koeffisientene og den avhengige variabelen (Y)
ingen av koeffisientene kan være logaritmer, opphøyd i noe eller liknende
de kan være ganget med noe
NB! X’ene kan være på ikke-lineære former
SLR.2
Dataene vi bruker i modellen må komme fra et tilfeldig utvlag
Alle i populasjonen har hatt like stor sjanse for å bli valgt
Hvis det ikke står noe om utvalgsprosessen i abstraktet er det rimelig å anta at forutsetningen er oppfylt
SLR.3
Det skal være variasjon i verdiene for den uavhengige variabelen, X
Hvis vi har ingen variasjon kan ikke modellen estimeres
Ingen variasjon dersom:
Alle respondentene i en undersøkelse har gitt samme svar
Standardavviket eller variasjonen er lik null
V(X) = 0
Variasjon dersom:
V(X) ≠ 0
SLR.4
Den forventede verdien av feilleddet u må være null for alle verdier av forklaringsvariabelen, X
Vi må forvente at modellen treffer uansett hvilken verdi man putter inn for X
E(ui | xi) = 0
De positive og negative feilene til hver X-verdi utlikner hverandre i gjennomsnitt, altså feilleddet har ingen systematisk positiv eller negativ verdi for alle verdiene av X
Forutsetningen brytes dersom en variabel som både er korrelert med X og Y er utelatt av modellen, altså at den utelatte variabelen er inkludert i feilleddet
NB! Siden det alltid bare er én forklaringsvariabel i en enkel regresjonsmodell, blir det vanskelig å oppfylle SLR.4
Hva kaller vi X når SLR.4 er henholdsvis oppfylt og brutt?
Oppfylt: X er eksogen
Brutt: X er endogen
SLR.5
Vi må forvente at variansen i feilleddet u må være den samme for alle verdier av X (homoskedastisitet)
Feilene skal ikke øke eller minke systematisk med X
Hvis SLR.5 ikke holder er modellen unbiased, men resultatene (standardfeilene) vil være mindre pålitelige
Heteroskedastisitet
Variert varians i feilleddet, brutt SLR.5
Hva er rimelig å konkludere med om SLR.1 - SLR.4 er oppfylt?
OLS-estimatorene er forventningsrette, altså at forventningsverdien til estimatene er lik de sanne populasjonsparameterne

Hva er rimelig å konkludere med om SLR.1 - SLR.5 er oppfylt?
OLS-estimatorene er BLUE, altså de beste lineære forventningsrette estimatorene
Konsekvenser ved brutt på hver av forutsetningene
SLR.1: regresjonsmodellen er ikke egnet til å beskrive den faktiske sammenhengen mellom X og Y
SLR.2: utvalget kan være skjevt, og OLS-estimatene kan bli forventningskjeve
SLR.3: Hvis X er konstant (ingen variasjon), kan vi ikke estimere helningskoeffisienten β^1
SLR.4: OLS-estimatene er ikke nødvendigvis forventningsrette, kan føre til utelatt variabel-bias og feilaktige konklusjoner om sammenhenger
SLR.5: OLS er ikke lengre garantert å være BLUE, vanlige standardfeil kan bli feil, og dermed også t-tester og konfidensintervaller
R2
et mål på hvor stor andel av variasjonen i den avhengige variabelen (Y) som forklares av regresjonsmodellen (forklaringskraften til modellen)
ligger mellom 0 og 1, der en høyere verdi betyr at modellen forklarer en større andel av variasjonen i Y
eks: R2 = 0,50 —> modellens forklaringskraft er 50%
NB! R2 kan være negativ om vi velger å utelate konstantleddet i en regresjonsmodell
Hva er problemet med R2?
R2 øker nesten alltid hvis vi inkluderer flere forklaringsvariabler, selv om variablene ikke har noen betydelig påvirkningskraft
ESS
explained sum of squares
summen av avstandene mellom estimert observasjon og gjennomsnittlig observasjon, kvadrert

TSS
total sum of squares
summen av avstandene mellom faktisk observasjon og gjennomsnittet, kvadrert

Hvordan ser regresjonsmodellen ut ved en lav vs. en høy R2?
Høy: observasjonene ligger nært regresjonslinja
Lav: observasjonene ligger lengre unna regresjonslinja

Hva er sammenhengen mellom utvalgskorrelasjon og R2 ved en enkel regresjonsmodell med konstantledd?
Utvalgskorrelasjonen ved en enkel regresjonsmodell med konstantledd er kvadratroten av R2
Fortegnet til korrelasjonen bestemmes av fortegnet til koeffisienten
Standardfeil til en regresjon (SER)
et mål på spredningen til residualene rundt regresjonslinjen, men også et mål på hvor presis regresjonsmodellen er (usikkerheten til et estimat)
viser hvor mye estimatet typisk varierer mellom ulike tilfeldige utvalg
jo lavere standardfeil desto mer presist er estimatet
det er et gjennomsnitt over hvor residualen faller over og under den estimerte linja
Standardfeilen til en regresjonskoeffisient (SE)
et mål på usikkerheten til den estimerte koeffisienten
viser hvor mye koeffisientestimatet typisk varierer mellom ulike tilfeldige utvalg
Standardavvik vs. standardfeil
Standardavvik: måler spredningen i dataene
Standardfeil: måler usikkerheten til estimatet
Hva sier lav vs. høy RSS oss?
Lav RSS: modellen estimerer presist (liten spredning i dataen)
Høy RSS: modellen estimerer upresist (stor spredning i dataen)
Hypotesetesting
en statistisk metode som brukes til å undersøke om det finnes tilstrekkelig grunnlag i utvalgsdataene til å forkaste en nullhypotese (H0) til fordel for en alternativ hypotese, basert på et valgt signifikansnivå
vi bruker hypotesetesting til å teste om observasjoner på utvalgsnivå også kan gjelde for populasjonsnivå
t-test
en statistisk hypotesetest som brukes til å undersøke om en enkelt regresjonskoeffisient er signifikant forskjellig fra en bestemt verdi (vanligvis null), ved å sammenlikne en beregnet t-verdi med en kritisk verdi eller bruke p-verdien
tester kun én variabel om gangen
t-verdi (testobservator)
et mål på hvor mange standardfeil en estimert koeffisient ligger unna verdien vi tester mot i hypotesen
p-verdi
sannsynligheten for å få en testobservator som er minst like ekstrem som den observerte, gitt at nullhypotesen er sann
Hva forteller en høy vs. lav p-verdi oss?
Lav: sterkere evidens mot H0
Høy: svakere evidens mot H0
Signifikanstest
en statistisk hypotesetest som brukes til å undersøke om det finnes tilstrekkelig statistisk evidens til å forkaste nullhypotesen
hypotesene ser alltid slik ut:
H0: B = 0 —> X har ikke en innvirkning på Y
HA: B ≠ 0 —> X har en innvirkning enten + eller - på Y
Forkastningsregler
en regel som bestemmer når vi skal forkaste nullhypotesen, basert på testobservatoren og den kritiske verdien, eller p-verdien og signifikansnivået
Kritisk verdi metoden
Sammenlikner den beregnede t- eller F-verdien med en kritisk verdi
Forkast H0 dersom testobservatoren ligger i forkastningsområdet
P-verdi metoden
Sammenlikner p-verdien med signifikansnivået
Forkast H0 dersom p-verdien er mindre enn signifikansnivået
“if the p is low the ho gotta go”
Jo lavere p-verdi, jo mer grunnlag har vi for å forkaste H0
Hva er logikken bak forkastningsregelen til p-verdi metoden?
Hvis p-verdien er mindre enn signifikansnivået betyr dette at vi kan godta dette siden sannsynligheten for å få en verdi mer ekstrem enn den vi har observert er mindre enn vi tillater med det gitte signifikansnivået
Hvis p-verdien er større enn signifikansnivået er det større sannsynlighet for å finne en t-verdi mer ekstrem enn den vi fant, enn vi er villige til å tillate i testen med det gitte signifikansnivået
Konfidensintervall
et intervall som angir usikkerheten rundt et estimat av en ukjent populasjonsparameter
et 95% konfidensintervall betyr at dersom vi gjentar utvalgsprosessen mange ganger, vil omtrent 95% av intervallene inneholde den sanne populasjonsparameteren
desto smalere intervall, desto sikrere er vi på estimatene
Den multiple regresjonsmodellen
en regresjonsmodell som undersøker sammenhengen mellom én avhengig variabel (Y) og to eller flere forklaringsvariabler (X)
modellen gjør det mulig å estimere sammenhengen mellom hver forklaringsvariabel og Y, gitt at de øvrige forklaringsvariablene holdes konstante
Interaksjonsterm
en variabel i en regresjonsmodell som fanger opp hvordan effekten av en forklaringsvariabel (X) på avhengighetsvariabelen (Y), avhenger av nivået på en annen forklaringsvariabel

MLR.1
Linearitet i parameterne
Lik som SLR.1
MLR.2
Tilfeldig utvalg
Lik som SLR.2
MLR.3
a) ingen perfekt kollinearitet
ingen x skal kunne blir skrevet som en lineær kombinasjon av andre x
kollinearitet går fint, bare ikke perfekt
b) nok variasjon
det må være nok variasjon i x’ene, og vi må ha nok observasjoner for å kunne estimere modellen
utvalgsstørrelsen må være stor nok til at: n ≥ k + 1
MLR.4
nullbetinget gjennomsnitt
lik som SLR.4
MLR.5
homoskedastisitet
lik som SLR.5
MLR.6
Normalfordelt feilledd
feilleddet er normalfordelt , med forventningsverdi null og konstant varians, betinget på forklaringsvariablene
feilleddet skal ikke være korrelert med noen av forklaringsvariablene
Feilledd vs. residual
Feilledd: forskjellen mellom den faktiske verdien av den avhengige variabelen (Y) og verdien som bestemmes av den sanne populasjonsmodellen
Residual: forskjellen mellom den faktisk verdien av den avhengige variabelen (Y) og verdien som bestemmes av den sanne populasjonsmodellen
Justert R2
et mål på hvor stor andel av variasjonen i den avhengige variabelen (Y) som forklares av regresjonsmodellem, justert for antall forklaringsvariabler og observasjoner
justert R2 modellen for å inkludere flere forklaringsvariabler som ikke forbedrer modellens forklaringskraft tilstrekkelig
Log-log-sammenheng
en regresjonsmodell der både den avhengige variablen og forklaringsvariabelen er logaritmetransformert
hvor mange prosent Y forventes å endre seg når X øker med 1%, alt annet likt
Log-lin-sammenheng
en regresjonsmodell der den avhengige variabelen er logaritmetransformert, mens forklaringsvariabelen er på vanlig nivå
koeffisienten ganget med 100 viser omtrent hvor mange prosent Y forventes å endre seg når X øker med én enhet, gitt alt annet likt
Lin-log-sammenheng
en regresjonsmodell der den avhengige variabelen er på vanlig nivå, mens forklaringsvariabelen er logaritmetransformert
koeffisienten delt på 100 viser omtrent hvor mange enheter Y forventes å endre seg når X øker med 1%, gitt alt annet likt
Lin-lin-sammenheng
en regresjonsmodell der både den avhengige variabelen og forklaringsvariabelen er på vanlig nivå
koeffisienten viser hvor mange enheter Y forventes å endre seg når X øker med én enhet, gitt alt annet likt
Dummyvariabel
en variabel som bare kan ha verdiene 0 og 1, og som brukes i regresjonsanalyse for å representere kategoriske egenskaper
verdien 1 betyr at observasjonen tilhører en bestemt kategori, mens 0 betyr at den tilhører referansekategorien
Dummyfellen
oppstår når man inkluderer en dummyvariabel for alle kategoriene i en kategorisk variabel, samtidig som modellen har et konstantledd
dette fører til perfekt multikollinearitet, slik at OLS ikke kan estimere alle koeffisientene entydig
2 regler for å unngå dummyfellen
dersom vi har en kvalitativ variabel med m mulige verdier, kan vi maksimalt inkludere (m - 1) dummyvariabler per kvalitativ variabel i tillegg til konstantleddet i modellen
hvis vi dropper konstant leddet, og vi kun har én kvalitativ variabel med m mulige verdier kan vi maksimalt inkludere m dummyvariabler
den lineære sannsynlighetsmodellen
en regresjonsmodell der den avhengige variabelen er en dummyvariabel
modellen bruker OLS til å estimere sannsynligheten for at Y = 1
regresjonskoeffisientene viser hvor mange prosentpoeng sannsynligheten endres når en forklaringsvariabel øker med én enhet, gitt alt annet likt