Psychologie générale - attention (partie 2)
 Call Kai
 Learn
 Practice Test
 Spaced Repetition
 Match
 Flashcards
 Knowt Play
1/50

There's no tags or description
Looks like no tags are added yet.
Name | Mastery | Learn | Test | Matching | Spaced | Call with Kai | Chat |
|---|
No analytics yet
Send a link to your students to track their progress
51 Terms
Qu'est-ce qu'un paradigme ?
Un paradigme est un modèle de référence, une structure de base à partir de laquelle on peut créer plusieurs expériences différentes (ex : paradigme de Stroop et l'expérience de Stroop émotionnel).
Quelle question posent les modèles d'attention sélective auditive, et quels sont les trois modèles ?
Comment sélectionne-t-on un message dans le bruit ambiant ? — Le paradigme de l'écoute dichotique. — Trois exemples de modèles qui diffèrent selon l'endroit où se trouve le goulot d'étranglement : filtrage précoce complet (modèle de Broadbent), filtrage précoce atténué (modèle de Treisman), filtrage tardif (modèle de Deutsch et Deutsch).
En quoi consiste le paradigme de l'écoute dichotique (Cherry, 1953) ?
Deux messages sont présentés auditivement, chacun via un canal auditif d'un casque. Les messages présentés dans l'oreille gauche et l'oreille droite se différencient (ou non) sur différentes caractéristiques : le genre, la langue, le thème, etc. Les participants doivent répéter à voix haute (« shadowing ») l'un des messages. On leur demande ensuite ce qu'ils ont retenu de l'autre message. // Écoute dichotique = présentation simultanée de deux stimuli auditifs distincts dans chacune des deux oreilles.
Quels sont les résultats de l'expérience d'écoute dichotique de Cherry (1953) ?
Les participants ne détectent que les caractéristiques physiques du message (et non le sens du message) auquel ils n'ont pas prêté attention (le genre, le ton de la voix). // Notes : voix grave d'un homme ; il peut dire le contenu de l'un mais pas de l'autre qu'il a filtré.
Qu'est-ce que le « Cocktail Party effect » ?
Capacité cognitive de notre cerveau à se focaliser sur une source sonore unique (comme une voix ou une conversation) tout en filtrant et en ignorant les bruits ambiants et les autres discussions.
Que postule le modèle de Broadbent (1958) ?
Développé à partir des expériences de Cherry (1953) sur l'écoute dichotique. Postule que le goulot d'étranglement est très tôt dans le traitement de l'information. Seules les caractéristiques sensorielles du stimulus 2 sont traitées. // Filtre précoce, situé entre le registre sensoriel (stockage de courte durée) et le traitement de l'information (reconnaissance, compréhension).

Donne l'exemple du registre sensoriel dans le modèle de Broadbent.
Exemple : registre sensoriel : lorsqu'on parle avec quelqu'un et qu'il y a du bruit autour, on reconnaît qu'il y a du bruit mais on ne comprend pas ce qui est dit.
Pourquoi le cerveau doit-il filtrer l'information ?
Les limites de l'attention : notre système sensoriel envoie trop d'infos → le cerveau doit sélectionner ce qui est pertinent. Il n'y a qu'une partie de la vague d'informations qui arrivent à notre conscience.
Quelle expérience a mis en difficulté le modèle de Broadbent ? (ex. « Qui 6 là ? » / « 4 va 1 »)
Si on demande de rapporter ce qui a été dit à gauche et à droite, les participants mélangent les informations selon ce qui a du sens (« Qui va là… »). Les participants ont donc traité les stimuli des deux côtés.
Que postule le modèle de Treisman (1964) ?
Postule que la localisation du goulot d'étranglement est flexible selon les ressources attentionnelles disponibles. Parfois, le traitement s'arrête tôt, parfois le traitement va plus loin et permet d'accéder à la signification d'une partie du stimulus 2. // Atténuateur : le stimulus 2 est un peu moins traité car il y a moins d'informations qui passent, mais l'information n'est pas bloquée avant le traitement.

Donne l'exemple illustrant le modèle de Treisman.
Situation de resto : beaucoup de conversations, et après on entend quelqu'un dire notre nom. Dans certaines situations, certaines informations sont si importantes pour nous qu'elles entrent dans notre conscience.
Que postule le modèle de Deutsch et Deutsch (1963) ?
Postule que la localisation du goulot d'étranglement est tard dans le traitement de l'information. Les stimuli 1 et 2 sont complètement traités et ce qui est le plus pertinent est sélectionné pour la réponse. // Filtre tardif, situé après le traitement de l'information et avant la réponse.

Explique le fonctionnement du filtre tardif (Deutsch et Deutsch).
C'est après le traitement qu'on décide quel stimulus est important pour nous. Deutsch explique aussi que, lorsque quelqu'un prononce notre nom, on traite l'information et le cerveau la considère comme importante. Donc, on a un traitement qui s'opère pour tous les stimuli, mais on sélectionne seulement ce qui est important pour nous après.
Comment se situent les modèles de Treisman et de Deutsch l'un par rapport à l'autre ?
Tous les deux corrects, deux manières différentes de voir la même chose : sélection d'informations jugées pertinentes dans les stimuli ambiants. Mais ces deux modèles se distinguent du premier (Broadbent).
Quel modèle d'attention sélective auditive explique le mieux les données actuelles ?
Les données actuelles s'expliquent le mieux avec le modèle de Treisman (1964). Cependant on n'a toujours pas une compréhension fine de comment le cerveau parvient à faire ce filtrage. Pour l'humain : c'est très facile de se focaliser sur une conversation malgré le bruit ambiant. Pour l'IA : c'est un problème très complexe, qui n'est pas encore entièrement résolu !
Quelles sont les approches de l'attention sélective visuelle ?
Comment trouve-t-on ce que l'on cherche ? — l'attention visuo-spatiale ; l'attention basée sur un objet ; l'attention déployée lors de la recherche visuelle (le modèle de Treisman, le modèle de Wolfe).
En quoi consiste la théorie du projecteur (Spotlight) ?
Proposée par Posner (1980). Lorsqu'on recherche quelque chose visuellement : on se focalise sur une petite partie à la fois et on ne voit pas le reste ; on doit alors bouger le champ attentionnel pour explorer une scène ; par exemple, dans le paradigme d'indiçage de Posner, on bouge le projecteur à gauche ou à droite. // On ne traite pas les informations qui ne se trouvent pas dans notre spot. Posner : expérience avec les cases lumineuses ; notre spot est attiré par la lumière ou va aller à gauche ou à droite selon la direction de la flèche.
En quoi consiste la théorie du zoom (Zoom lens) ?
Proposée par Eriksen et St James (1986). Lorsqu'on recherche quelque chose visuellement, on peut augmenter ou réduire le champ attentionnel selon les besoins. Par ex. : quand on conduit, on peut avoir un champ attentionnel large pour voir tout ce qui se passe et puis faire un focus sur une zone plus précise si on détecte un danger.
En quoi consiste la théorie de l'attention divisée (Split Attention) ?
Proposée par Awh et Pashler (2000). Lorsqu'on recherche quelque chose visuellement : on peut se focaliser sur deux ou plusieurs zones non-adjacentes (multiple projecteurs) ; on ne traite pas les aires qui sont entre les zones d'attention. // Différence avec Posner et l'autre : on peut avoir plusieurs spots d'attention. Par exemple, les spots d'attention sont sur les t-shirts blancs avec l'expérience du gorille.
Où en sont les modèles d'attention visuo-spatiale actuellement ?
Aucun modèle n'explique à lui seul toutes les données. Les recherches actuelles suggèrent que l'attention visuo-spatiale est flexible : elle peut se rétrécir, s'élargir (théorie du zoom) ou, dans certains cas, se scinder (théorie de l'attention divisée).
Qu'est-ce que l'attention basée sur un objet (Object-based attention) ?
On peut focaliser son attention sur un objet plutôt qu'un autre même lorsque les deux objets sont superimposés (= placer un élément par-dessus un autre de manière à ce que les deux restent visibles). Dans l'exemple, selon qu'on se concentre sur le visage ou la maison, ce sont des aires différentes de reconnaissance d'objets qui sont activées dans le cerveau.
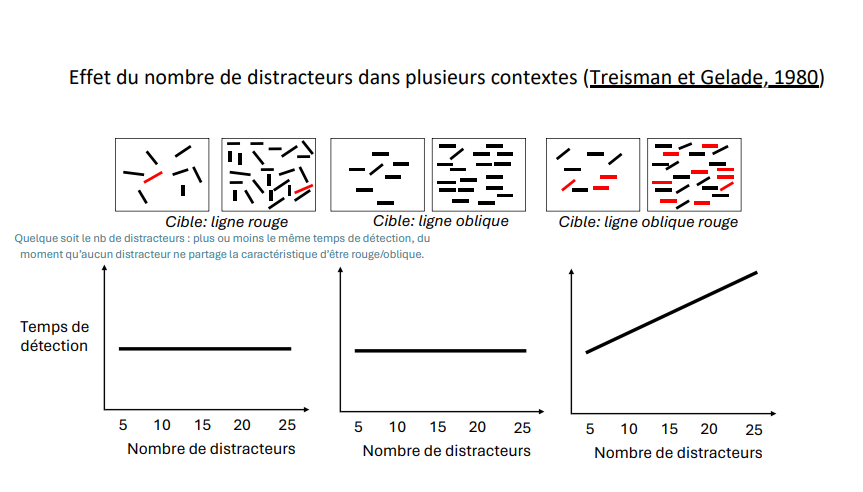
Quelle est l'expérience classique de Treisman sur la recherche visuelle ?
Comment trouve-t-on les objets que l'on cherche dans une scène visuelle ? Expérience classique de Treisman : recherche d'une seule propriété versus recherche d'une conjonction de propriétés. Recherche d'une seule propriété : la cible et les distracteurs se différencient par une seule propriété (facile). Recherche d'une conjonction de propriétés : la cible et les distracteurs se différencient par deux propriétés (plus difficile).
Quel est l'effet du nombre de distracteurs (Treisman et Gelade, 1980) ?
Quel que soit le nombre de distracteurs : plus ou moins le même temps de détection, du moment qu'aucun distracteur ne partage la caractéristique d'être rouge/oblique. (Conditions : cible = ligne rouge ; cible = ligne oblique ; cible = ligne oblique rouge.)
Que postule le modèle de Treisman et Gelade (1980) ?
On crée automatiquement des cartes spatiales avec des propriétés de couleur, orientation, intensité : une carte par propriété via le système attentionnel bottom-up.
Si la cible se distingue des distracteurs par une propriété, il suffit de lire la carte générée automatiquement (La carte maître n'intervient que quand il faut lier plusieurs caractéristiques entre elles).
On combine les propriétés via une carte « maître » via le système attentionnel top-down. Si la cible se distingue des distracteurs par plusieurs propriétés, la localisation de l'objet dépend de l'intégration réalisée dans la carte maître (et cela prend plus de temps).
Les caractéristiques sont représentées sur des cartes séparées ; l'attention est nécessaire pour intégrer ou lier les caractéristiques.
Chaque carte prise isolément est ambiguë, puisque plusieurs objets possèdent une propriété similaire à celle de la cible, par exemple, des objets qui sont rouges et des objets qui sont obliques. Il faut déplacer l'attention d'un objet à l'autre pour vérifier où les deux propriétés coïncident. D'où un temps qui augmente avec le nombre de distracteurs.

Que postule le modèle de Wolfe (2003) ?
Certaines localisations dans l'espace reçoivent plus d'activation que d'autres car elles correspondent à l'emplacement de propriétés fort différentes des propriétés dans les emplacements voisins (processus bottom-up).
Certaines localisations reçoivent plus d'activation car elles correspondent à l'emplacement de propriétés que l'on cherche activement (processus top-down).
Les processus bottom-up et top-down s'additionnent pour donner une carte d'activation globale : plus l'activation est élevée, plus il y a de chances que l'attention se focalise sur cet endroit.

Par quoi les cartes d'activation sont-elles influencées (Wolfe) ?
La saillance bottom-up (caractéristiques distinctives dans la scène).
Les buts de la recherche (caractéristiques de la cible). Les activations provenant des différentes dimensions se combinent ; les localisations ayant une activation plus élevée sont examinées en priorité par l'attention.
Exemple : quand on cherche son téléphone fluo → post-it fluo, objet rectangulaire → activation, ça attire l'attention.
Quelle est la différence entre le modèle de Treisman et Gelade (1980) et celui de Wolfe (2003) ?
Treisman et Gelade : on scanne l'ensemble du champ visuel pour trouver la cible ; TOUTES les localisations sont des candidates potentielles, l'attention parcourt les localisations pour trouver la cible ; cartes qui correspondent à la répartition spatiale de différents traits.
Wolfe : on ne scanne pas l'ensemble du champ visuel ; certaines localisations sont plus saillantes que d'autres par la combinaison de l'attention bottom-up et top-down ; CERTAINES localisations sont prioritaires et guident l'attention ; cartes de saillance qui montrent les localisations où il y a des propriétés qui « sautent aux yeux ».
Peut-on prédire où les personnes vont regarder ?
Utilisation d’une carte de saillance générée artificiellement sur base de l'analyse des propriétés d'une scène et des mécanismes de perception et d'attention que l'on connaît (application en robotique, intelligence artificielle, etc.).
Carte de chaleur : vers le bleu = peu d'activation ; vers le rouge = cette zone-là est importante. (Le contenu de la vidéo ne fait pas partie de la matière d'examen.)
Que postule le modèle de Kahneman (1973) ?
Postule un réservoir unique d'où il faut puiser les ressources nécessaires.
Postule un processeur central qui va :
analyser les tâches et les intentions afin d'estimer les ressources nécessaires à l'une ou l'autre tâche ;
puiser les ressources attentionnelles nécessaires et les attribuer dans l'exécution des tâches.

Quel est le problème du modèle de Kahneman (1973) ?
Ce modèle n'explique pas pourquoi il est plus facile de faire deux tâches différentes à la fois (conduire et parler) que deux tâches similaires à la fois (lire et parler).
Que postule le modèle d'Allport (1980) ?
Postule plusieurs réservoirs attentionnels (sans préciser le nombre) : par ex. un réservoir de capacité attentionnelle pour la vision et un pour l'audition.
Chaque tâche puise dans le réservoir correspondant au type de traitement qu'elle mobilise :
Si elles sont différentes, elles vont recruter dans des réservoirs distincts, ce qui rend la tâche plus facile à réaliser.
Si les tâches sont similaires, elles vont recruter dans un même réservoir : ressources limitées.
+ La complexité des tâches est aussi importante : on va avoir de la difficulté si la tâche est complexe, même si ce sont des réservoirs différents. On a également tous une sensibilité différente : certaines tâches qui nous semblent plus naturelles peuvent être difficiles pour d'autres.
Quelle est la différence entre la situation de tâche double et le multitasking ?
Tâche double :
faire deux tâches en même temps ;
mobilise l'attention divisée ;
exemple : étudier pendant qu'on regarde un film ou un match de foot en même temps (ou écouter la prof pendant qu'on écrit nos notes).
Multitasking :
alterner rapidement entre plusieurs tâches ;
mobilise la flexibilité attentionnelle ;
exemple : étudier et regarder toutes les 5 min les messages sur les réseaux sociaux (on passe de l'un à l'autre : on écoute la prof, et après on checke le téléphone).
Que montrent les études sur le multitasking digital intensif ?
La majorité des études montrent que les personnes qui pratiquent le multitasking de manière intensive :
ont l'illusion d'être plus efficaces ;
ont objectivement de moins bonnes performances dans des tâches de mémoire (de travail) et de contrôle attentionnel (plus de distraction) ;
trouvent avant tout une satisfaction émotionnelle (échappatoire) via les distractions des médias digitaux. → Difficile de savoir si les personnes font du multitasking intensif parce qu'elles sont distraites au départ ou si elles deviennent plus distraites suite au multitasking intensif (Exemple : lorsqu'on est en train d'écouter la prof et qu'on reçoit des notifications de messages, qu'on aille répondre et qu'on doive après se remettre dans le bain : on perd la possibilité de contrôle).
Quel est l'effet de répondre sans contrôle aux sollicitations des médias digitaux ?
Répondre (sans contrôle) aux sollicitations des médias digitaux renforce le système attentionnel exogène/bottom-up au détriment du système endogène/top-down.
Quel est l'effet d'un niveau modéré de multitasking ?
Un niveau modéré de multitasking permet de développer la flexibilité attentionnelle (pour autant qu'on parvienne à accomplir toutes les tâches).
Répondre de manière contrôlée aux sollicitations des médias digitaux sans perdre de vue les buts des différentes tâches renforce le contrôle que l'on a dans le passage du système attentionnel exogène/bottom-up vers le système endogène/top-down et vice-versa. (on garde le contrôle, résistance aux choses qui sautent aux yeux)
Le multitasking n'est pas forcément mauvais (contrairement à ce que disent certains headlines), mais il faut absolument savoir garder le contrôle : c'est nous qui devons décider quand on regarde notre portable afin d’entraîner la flexibilité de notre attention et de ne pas nous laisser emporter par les bips et les sons.
Quelles sont les caractéristiques des processus automatiques (Shiffrin et Schneider, 1977) ?
Rapides ;
fonctionnent en parallèle ; (plusieurs processus tournent en même temps, sans se gêner. Tu peux marcher, respirer et reconnaître des visages simultanément)
consomment peu de ressources attentionnelles ;
difficiles à interrompre ;
peuvent être exécutés simultanément avec une activité contrôlée. (Lié au bottom-up.)
Quelles sont les caractéristiques des processus contrôlés (Shiffrin et Schneider, 1977) ?
Lents ;
fonctionnent en séquence (les processus se font l'un après l'autre, en file d'attente. C'est le cas des processus contrôlés : comme ils puisent dans une ressource limitée, ils ne peuvent pas être faits simultanément. On est obligé d'alterner, de passer de l'une à l'autre) ;
consomment beaucoup de ressources attentionnelles ;
faciles à interrompre ;
peuvent difficilement être exécutés simultanément avec une autre activité contrôlée. (Lié au top-down.)
Comment considère-t-on actuellement la distinction automatique / contrôlé ?
On considère la distinction entre processus automatiques et processus contrôlés comme variant le long d'un continuum. Certains processus peuvent s'automatiser avec le temps (et avec l'apprentissage, par ex. la conduite d'une voiture).
La conduite d'une voiture : il y a plusieurs tâches auxquelles on doit faire attention (le frein, l'accélérateur, etc.) ; plus tard, tout devient automatique.
Qu'est-ce qu'une échelle de Likert ?
Couramment utilisée.
Mesure des attitudes, opinions, perceptions.
Toujours des degrés d'accord (ex. de 1 « en désaccord total » à 6 « en accord total »).
Certaines phrases sont formulées de manière inversée aux autres : un 6 n'a pas la même signification dans une question que dans l'autre (par exemple, je mets un six pour l'affirmation « je suis une personne distraite » mais je ne peux pas mettre un 6 à la phrase « je ne me perds pas dans mes pensées » ⇒ contradictoire).

Quels sont les deux types de distractions, et comment y résister ?
Distractions par des pensées intrusives et distractions par des éléments externes. Dans les deux cas, l'attention exogène/bottom-up est attirée par les distractions. Pour résister aux distractions, il faut mobiliser son attention endogène/top-down.
Chez certains, l’attention bottom-up surpasse l’attention contrôlée.
Quelle est la différence entre différences inter-individuelles et intra-individuelles de l'attention ?
Différences inter-individuelles : certaines personnes (dans une même culture) ont plus de facilités que d'autres dans des tâches attentionnelles.
Différences intra-individuelles : les capacités attentionnelles varient aussi chez un même individu (fatigue, etc.).
Les processus contrôlés sont plus susceptibles que les processus automatiques aux variabilités.
Quelles différences culturelles observe-t-on dans l'attention ?
Les cultures collectivistes (comme en Asie) ont un champ attentionnel plus large et tiennent plus facilement compte de l'ensemble des éléments dans une scène visuelle (approche holistique). On fait plus attention aux autres, à la globalité.
Les cultures individualistes (comme en Europe ou en Amérique du Nord) ont un champ attentionnel plus focalisé (approche analytique dans la description d'une scène). On regarde moins ce qui se passe autour, plutôt un focus sur les détails.
Cette différence se manifeste davantage lorsque des processus attentionnels contrôlés sont mobilisés.
! C'est une tendance que l’on observe ; ça ne veut pas dire que c’est une vérité pour tout le monde.
Décris l'expérience de Masuda et Nisbett (2001).
Des participants japonais et américains visionnent des vidéos de scènes naturelles.
Dans les scènes :
(1) gros poissons qui bougent,
(2) petits poissons qui bougent et
(3) un arrière-fond qui ne bouge pas beaucoup.
Après le visionnage, on demande : qu'avez-vous vu ?
Les Japonais faisaient plus de liens entre les poissons et l'arrière-fond (« il y avait un petit poisson qui grimpait sur une algue ») ;
Les Américains décrivaient davantage les éléments séparément (« il y avait 5 gros poissons, il y avait une grenouille aussi »). // Les Japonais sont plus holistiques dans leur manière de percevoir et de raisonner.
Qu'est-ce que la distractibilité ?
Est engendrée par des difficultés d'attention endogène/top-down.
S'observe dans des troubles développementaux comme le TDAH (trouble du déficit de l'attention avec ou sans hyperactivité).
S'observe chez certains patients avec lésions cérébrales acquises (traumatisme crânien, AVC, etc.).
Qu'est-ce que l'héminégligence spatiale ?
Se manifeste par des difficultés à explorer le champ attentionnel gauche ou droit.
C'est le champ opposé à la localisation de la lésion qui est affecté : lésion droite → négligence gauche ; lésion gauche → négligence droite.
Trouble assez fréquemment observé suite à un accident vasculaire cérébral (AVC). // Le plus courant, c'est une lésion droite qui produit des difficultés sur la gauche.
Comment se manifeste concrètement une héminégligence gauche ?
La personne ignore ce qui se passe à gauche (par exemple) : elle va se raser à moitié, manger la moitié de l'assiette, se cogner sans cesse à gauche lorsqu'elle marche car elle ne remarque pas les obstacles. Si on parle sur la gauche de la personne, elle ne va pas être attentive aux sons provenant de la gauche. Certaines personnes ont également ce problème au niveau des mouvements : si on demande de bouger le bras gauche, elles diront l'avoir bougé même si ce n'est pas le cas. Lorsqu'elles mangent la moitié de l'assiette ou dessinent la moitié, elles pensent avoir réellement réalisé l'entièreté de la tâche sans se rendre compte qu'elles ont négligé la partie gauche ou droite.

Qu'est-ce que le biais attentionnel envers la menace (anxiété) ?
Se manifeste par une attention accrue portée sur des indices de menace.
Dans le cas de l'anxiété sociale, par exemple, l'attention peut se focaliser sur tout signe potentiel de désapprobation ou de rejet.
Ces biais attentionnels peuvent impliquer les processus attentionnels bottom-up ET top-down.
Ces biais attentionnels peuvent être une cible d'intervention en psychologie clinique.
Quelles sont les étapes bottom-up des modèles de Treisman et Gelade (1980) et de Wolfe (2003) ?
Treisman et Gelade : Cartes qui correspondent à la répartition spatiale de différents traits.
Wolfe : Cartes de saillances qui montrent les localisations où il y a des propriétés qui «sautent aux yeux», les caractéristiques distinctives dans la scène (ex: couleurs fortes).

Quelles sont les étapes top-down des modèles de Treisman et Gelade (1980) et de Wolfe (2003) ?
Treisman et Gelade : Intégration des cartes bottom-up (master map)
Wolfe : Cartes d’activation en fonction des traits recherchés activement, les caractéristiques de la cible.

Quels sont les deux modèles de réservoirs attentionnels ?
Le modèle de Kahneman (1973) et le modèle d’Allport (1980).
Pourquoi est-il possible de réaliser une tâche automatique avec une tâche contrôlée mais pas deux contrôlées ?
Car deux processus contrôlés devront se battre pour avoir les ressources d’attention.